
LFM2.5-DSpark: LiquidAI erzielt bis zu 3,2-fach schnellere Inferenzgeschwindigkeiten
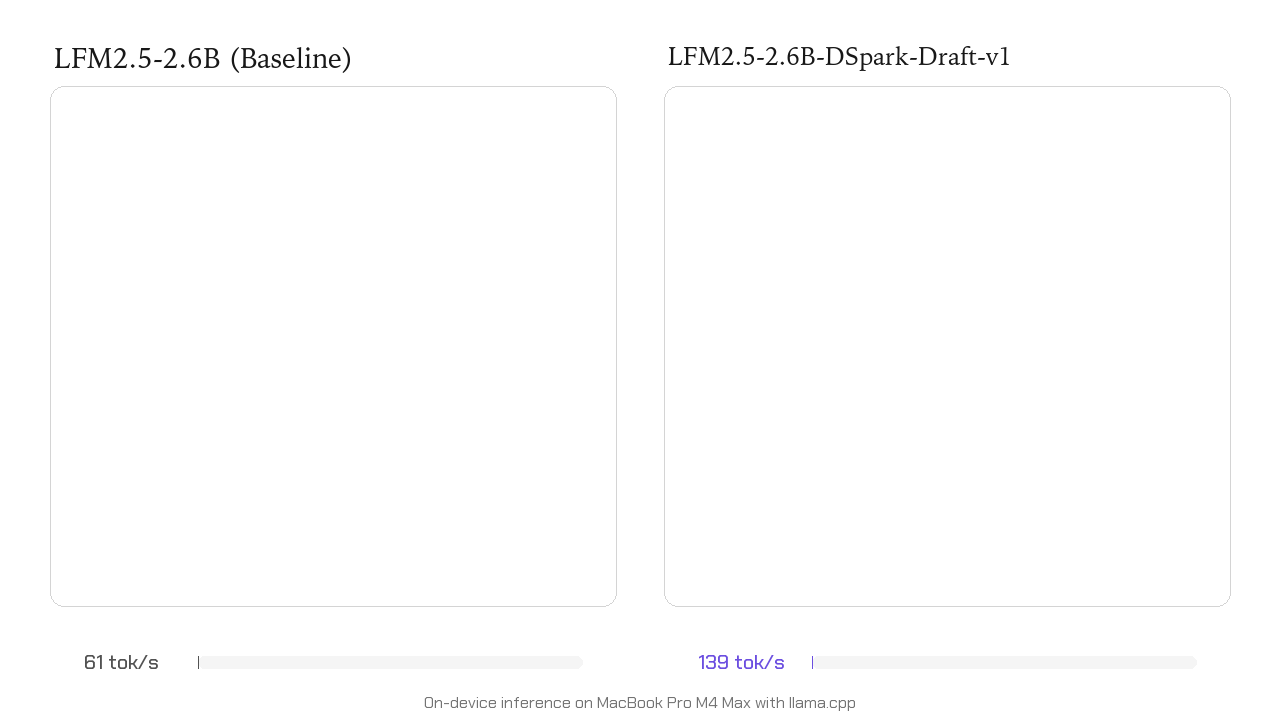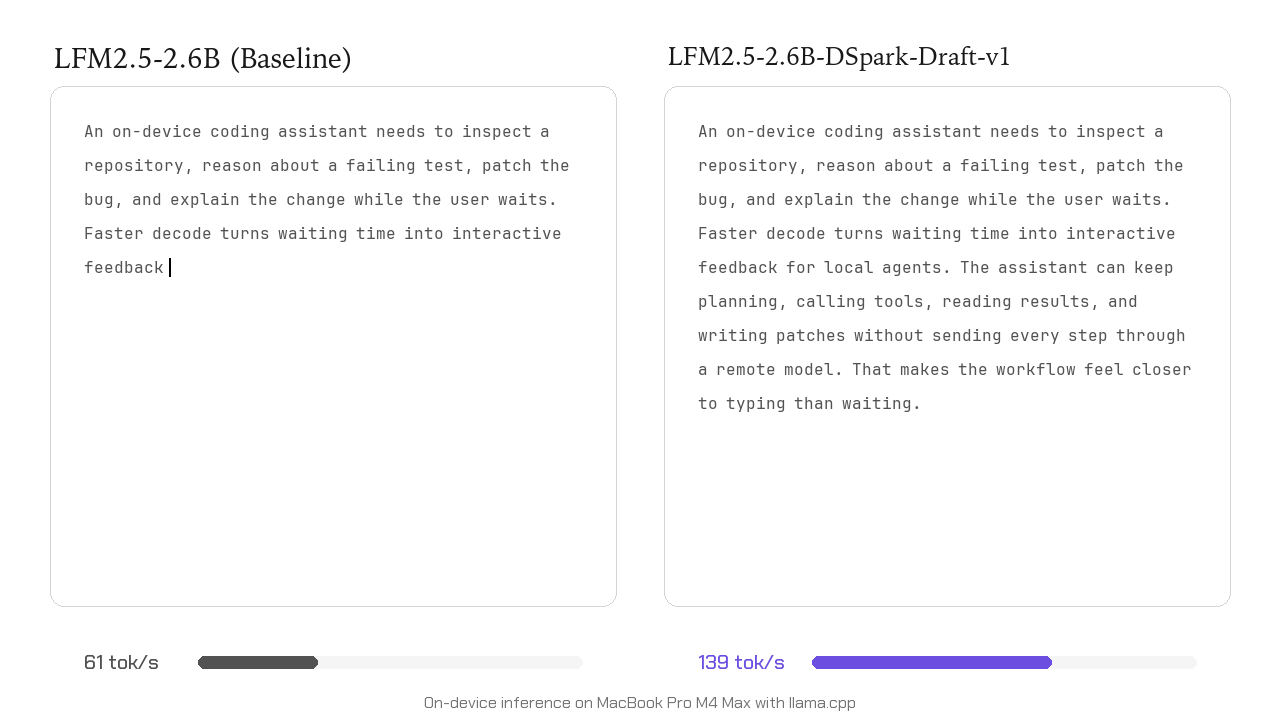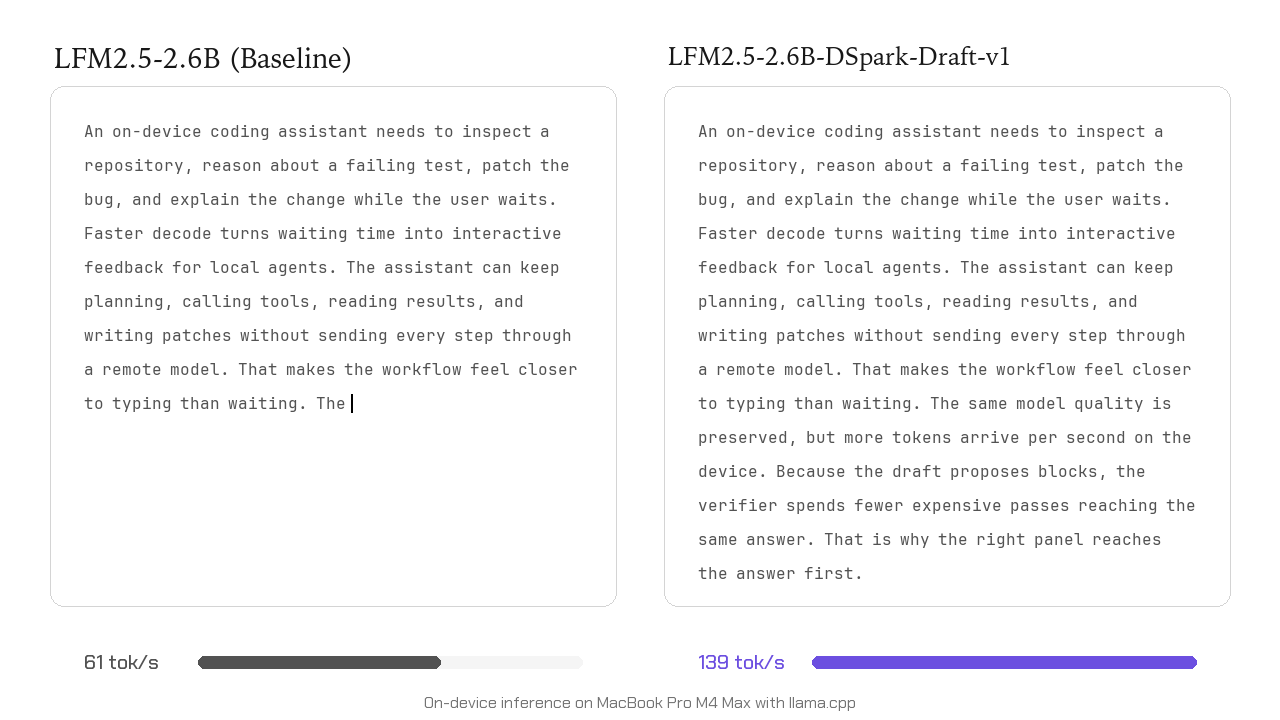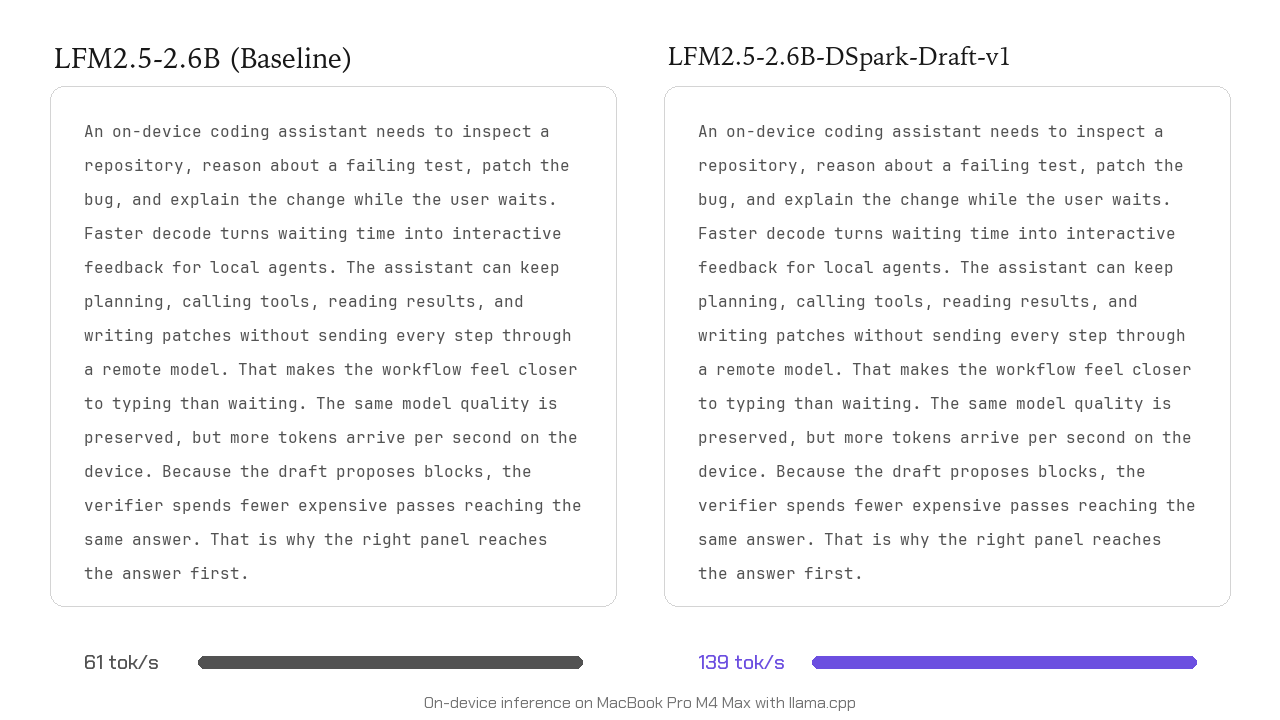
In einer aktuellen Veröffentlichung auf dem Hugging Face Blog hat LiquidAI signifikante Leistungssteigerungen für sein neuestes Modell, LFM2.5-DSpark, bekannt gegeben. Die zentrale Neuerung ist eine beeindruckende Beschleunigung der Inferenzgeschwindigkeit um das bis zu 3,2-fache. Dieser Fortschritt markiert einen wichtigen Meilenstein in der Entwicklung effizienter KI-Modelle, da die Inferenzgeschwindigkeit direkt die Skalierbarkeit und die Betriebskosten von KI-Anwendungen beeinflusst. Der am 20. August 2026 veröffentlichte Bericht unterstreicht das Bestreben von LiquidAI, die Performance ihrer Liquid Foundation Models (LFM) kontinuierlich zu optimieren. Während detaillierte technische Spezifikationen in der Kurzmeldung noch ausstehen, deutet der enorme Geschwindigkeitszuwachs auf tiefgreifende Optimierungen in der Modellarchitektur oder den Verarbeitungsalgorithmen hin, die insbesondere für rechenintensive Echtzeitszenarien von entscheidender Bedeutung sind.
Die wichtigsten Punkte
- Massiver Geschwindigkeitsvorteil: LFM2.5-DSpark erreicht eine Inferenzgeschwindigkeit, die bis zu 3,2-mal schneller ist als bisherige Standards oder Vorgängerversionen.
- Offizielle Ankündigung: Die Details wurden am 20. August 2026 über den renommierten Hugging Face Blog durch LiquidAI publiziert.
- Fokus auf Effizienz: Die Optimierung zielt primär auf die Reduzierung der Latenz und die Steigerung des Durchsatzes bei der Modellausführung ab.
- Technologische Evolution: Das Modell ist Teil der LFM-Serie (Liquid Foundation Models) und stellt eine spezifische Weiterentwicklung unter dem Namen „DSpark“ dar.
Analyse
Der Durchbruch bei der Inferenzgeschwindigkeit
Die Inferenz – also der Moment, in dem ein KI-Modell auf eine Eingabe reagiert und ein Ergebnis liefert – ist in der praktischen Anwendung oft der kritische Flaschenhals. Mit der Vorstellung von LFM2.5-DSpark adressiert LiquidAI dieses Problem direkt. Eine Steigerung um den Faktor 3,2 ist in der Welt der künstlichen Intelligenz ein außergewöhnlicher Sprung. In der Praxis bedeutet dies, dass Systeme, die auf dieser Technologie basieren, entweder dreimal so viele Anfragen gleichzeitig bearbeiten können oder die Antwortzeit für den Endnutzer drastisch sinkt.
Dieser Performance-Schub ist besonders relevant, da die Hardware-Anforderungen für moderne KI-Modelle stetig steigen. Eine Software-seitige oder architektonische Optimierung, die eine solche Beschleunigung ohne den massiven Zukauf neuer Hardware ermöglicht, bietet Unternehmen einen enormen Wettbewerbsvorteil. LiquidAI scheint hier einen Weg gefunden zu haben, die Effizienz der Modellausführung auf ein neues Niveau zu heben.
Die Rolle von LiquidAI und Hugging Face
Die Wahl des Hugging Face Blogs als Plattform für diese Ankündigung unterstreicht die Bedeutung der Zusammenarbeit innerhalb der KI-Community. LiquidAI nutzt die Reichweite und die technische Infrastruktur von Hugging Face, um Entwickler und Unternehmen über die Fortschritte der Liquid Foundation Models (LFM) zu informieren.
Obwohl die vorliegende Meldung keine detaillierten Einblicke in die mathematischen Hintergründe von „DSpark“ gibt, lässt der Name auf eine spezialisierte Datenverarbeitung oder eine optimierte Funken-Struktur (Spark) innerhalb der Modellarchitektur schließen. Die LFM-Modelle sind bereits für ihre Flexibilität bekannt, und die Version 2.5-DSpark scheint diese Stärken nun mit einer extremen Geschwindigkeit zu kombinieren. Es ist davon auszugehen, dass diese Optimierungen sowohl die Rechenlast auf GPUs reduzieren als auch die Energieeffizienz verbessern.
Bedeutung für die KI-Branche
Die Ankündigung von LFM2.5-DSpark hat weitreichende Implikationen für die gesamte Branche. Erstens setzt es die Konkurrenz unter Druck, ähnliche Effizienzsteigerungen zu liefern. In einer Zeit, in der die Kosten für KI-Inferenz (Inference Costs) einen erheblichen Teil der Betriebskosten von Tech-Unternehmen ausmachen, ist eine 3,2-fache Beschleunigung ein starkes Argument für den Wechsel auf LiquidAI-Modelle.
Zweitens ermöglicht diese Geschwindigkeit neue Anwendungsfelder. Echtzeit-Übersetzungen, komplexe autonome Systeme und interaktive KI-Assistenten profitieren massiv von geringeren Latenzen. Wenn die Inferenzzeit sinkt, rücken Anwendungen in greifbare Nähe, die zuvor aufgrund technischer Verzögerungen als nicht praktikabel galten. LFM2.5-DSpark könnte somit als Katalysator für die nächste Generation von KI-gestützten Echtzeit-Diensten fungieren.
Häufig gestellte Fragen
Was genau bedeutet „3,2x schnellere Inferenz“ für Unternehmen?
In der Praxis bedeutet dies, dass die gleiche Hardware-Infrastruktur nun das 3,2-fache an Arbeitslast bewältigen kann. Dies führt entweder zu einer massiven Senkung der Cloud-Computing-Kosten oder zu einer signifikanten Verbesserung der Reaktionszeit für die Endnutzer der KI-Anwendung.
Ist LFM2.5-DSpark bereits für die Öffentlichkeit verfügbar?
Die Ankündigung erfolgte am 20. August 2026 auf dem Hugging Face Blog. Interessierte Entwickler und Unternehmen sollten die entsprechende Modell-Seite auf Hugging Face besuchen, um Informationen über die Verfügbarkeit der Gewichte und die Lizenzbedingungen zu erhalten.
Welche Modelle werden durch LFM2.5-DSpark ersetzt?
LFM2.5-DSpark stellt eine Weiterentwicklung innerhalb der Liquid Foundation Model Serie dar. Es ist darauf ausgelegt, bestehende Implementierungen der LFM-Reihe durch eine performantere Version zu ergänzen oder zu ersetzen, wobei der Fokus speziell auf der Optimierung der Ausführungsgeschwindigkeit liegt.


