
LFM2.5-VL-3B: Neues KI-Modell für verbesserte und schnellere Bildverarbeitungsfunktionen auf Edge-Geräten
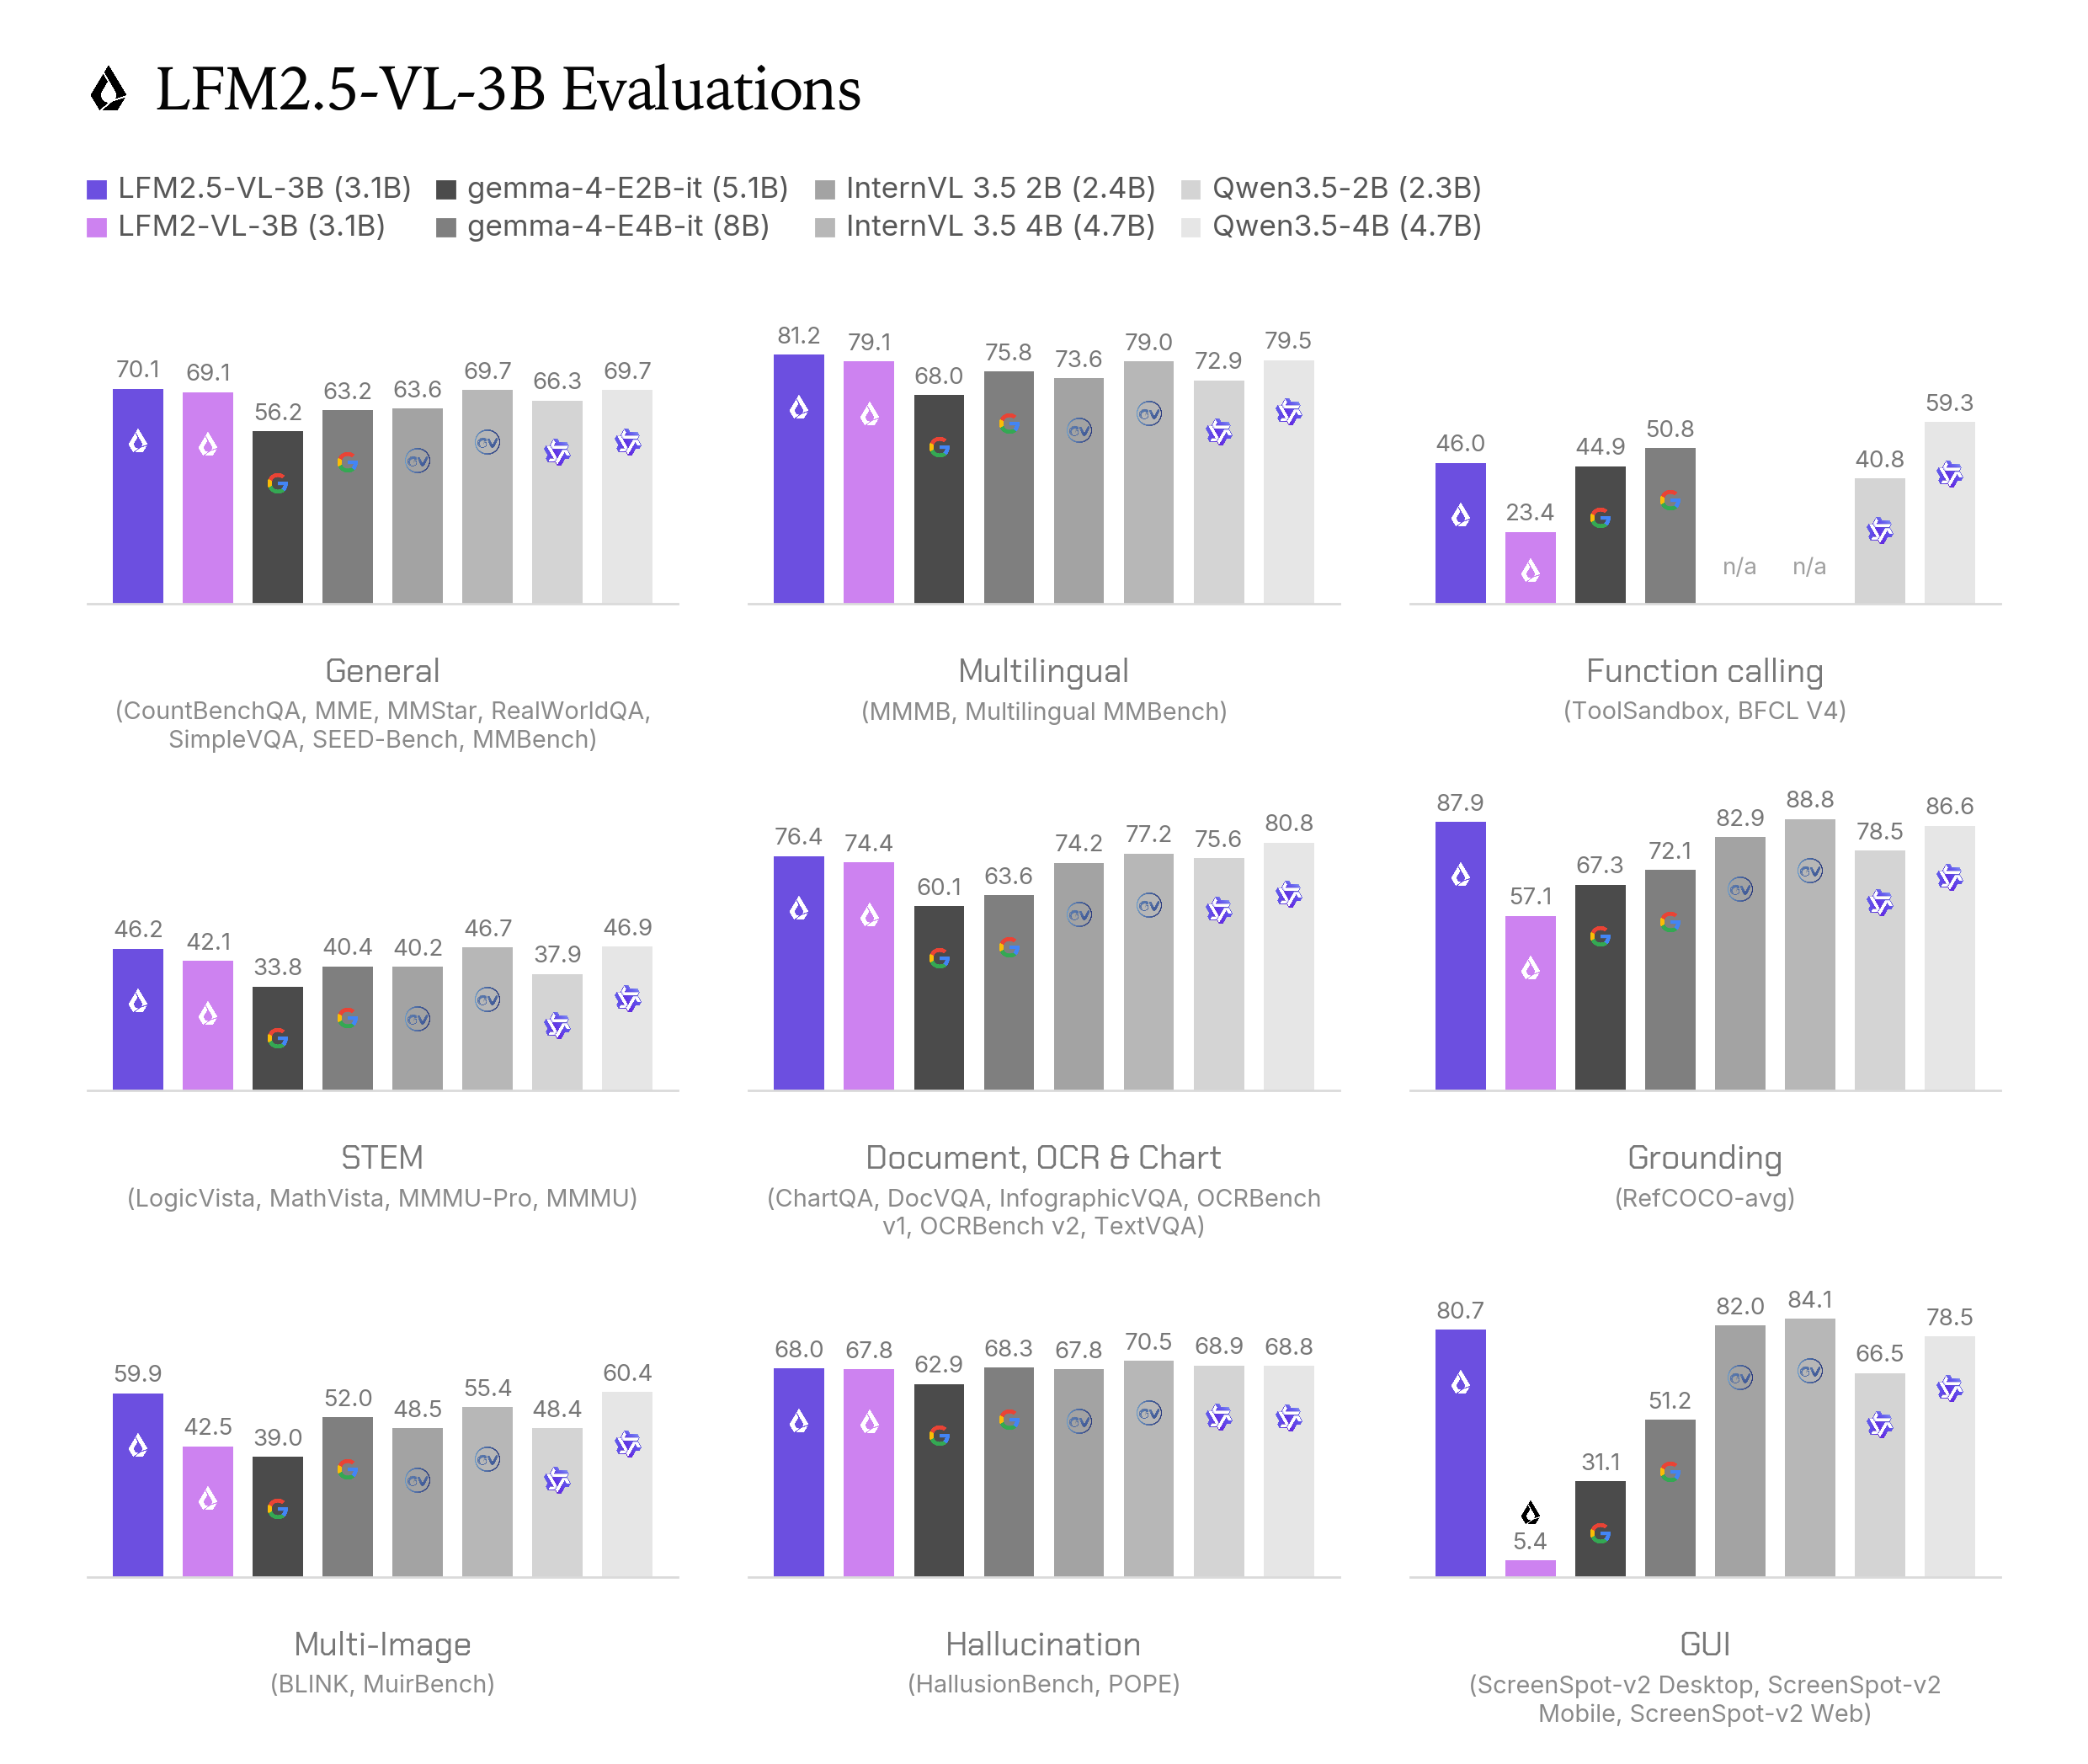
Mit der Vorstellung von LFM2.5-VL-3B wird ein neues Modell präsentiert, das darauf ausgelegt ist, leistungsstarke Vision-Fähigkeiten direkt auf Edge-Geräte zu bringen. Die Ankündigung hebt hervor, dass das Modell sowohl eine bessere Qualität als auch eine höhere Geschwindigkeit bei der Bildverarbeitung ermöglicht. Durch die Optimierung für den Edge-Bereich adressiert LFM2.5-VL-3B die wachsende Nachfrage nach effizienten KI-Lösungen, die lokal und ohne ständige Cloud-Anbindung funktionieren. Das Modell, welches über den Hugging Face Blog veröffentlicht wurde, kombiniert Vision- und Language-Komponenten (VL) in einer kompakten 3B-Parameter-Struktur. Dies markiert einen wichtigen Schritt für Anwendungen, bei denen Latenz und Ressourceneffizienz entscheidend sind, während gleichzeitig die Leistungsfähigkeit der visuellen Analyse gesteigert wird.
Die wichtigsten Punkte
- Vorstellung des neuen Modells LFM2.5-VL-3B für die Bildverarbeitung.
- Fokus auf verbesserte Leistung und gesteigerte Geschwindigkeit.
- Spezielle Optimierung für den Einsatz in Edge-Computing-Umgebungen.
- Kombination von Vision- und Language-Fähigkeiten (VL) in einer 3B-Konfiguration.
- Veröffentlichung und Dokumentation über die Plattform Hugging Face.
Analyse
Optimierung für den Edge-Bereich
Die Entwicklung von LFM2.5-VL-3B konzentriert sich primär auf die Anforderungen des Edge-Computings. In diesem Bereich ist es entscheidend, dass KI-Modelle trotz begrenzter Hardware-Ressourcen eine hohe Performance erbringen. Die Bezeichnung "Edge" im Titel verdeutlicht, dass das Modell darauf ausgelegt ist, direkt auf Endgeräten ausgeführt zu werden. Dies reduziert die Abhängigkeit von externen Servern und ermöglicht eine schnellere Datenverarbeitung vor Ort. Die im Titel versprochenen "besseren und schnelleren" Fähigkeiten deuten darauf hin, dass bei der Entwicklung ein besonderes Augenmerk auf die Balance zwischen Recheneffizienz und Analysegenauigkeit gelegt wurde.
Architektur und Leistungsversprechen
Das Modell trägt die Kennzeichnung "3B", was üblicherweise auf eine Größe von 3 Milliarden Parametern hindeutet. In der Hierarchie moderner KI-Modelle gilt diese Größe als kompakt genug für lokale Anwendungen, aber dennoch leistungsfähig genug für komplexe Aufgaben. Der Zusatz "VL" steht für "Vision-Language" und bestätigt, dass es sich um ein multimodales Modell handelt, das in der Lage ist, visuelle Informationen zu verarbeiten und diese in einen sprachlichen Kontext zu setzen oder durch Sprache gesteuert zu werden. Das Hauptziel von LFM2.5-VL-3B ist es, diese multimodalen Prozesse zu beschleunigen, ohne dabei Abstriche bei der Qualität der Ergebnisse zu machen.
Bedeutung für die KI-Branche
Die Einführung von LFM2.5-VL-3B unterstreicht einen deutlichen Trend in der KI-Branche: die Abkehr von rein Cloud-basierten Riesensystemen hin zu effizienten, lokalen Modellen. Für Entwickler und Unternehmen bedeutet dies, dass anspruchsvolle Bildverarbeitung nun auch in Umgebungen möglich wird, in denen Bandbreite begrenzt oder Datenschutzanforderungen hoch sind. Die Kombination aus Geschwindigkeit und verbesserter Vision-Kapazität in einem 3B-Modell setzt neue Maßstäbe für das, was auf Edge-Hardware möglich ist. Es fördert die Verbreitung von KI in Bereichen wie Robotik, mobilen Anwendungen und industrieller Automatisierung, wo Echtzeit-Reaktionen auf visuelle Reize unerlässlich sind.
Häufig gestellte Fragen
Was ist das Hauptziel von LFM2.5-VL-3B?
Das Hauptziel ist es, Bildverarbeitungsfunktionen (Vision Capabilities) auf Edge-Geräten sowohl schneller als auch qualitativ hochwertiger zur Verfügung zu stellen.
Für welche Einsatzgebiete ist das Modell gedacht?
Das Modell ist speziell für den Einsatz am "Edge" optimiert, also für die lokale Ausführung auf Endgeräten, bei denen es auf geringe Latenz und hohe Effizienz ankommt.
Was bedeutet die Bezeichnung VL im Modellnamen?
VL steht für Vision-Language. Dies bedeutet, dass das Modell in der Lage ist, sowohl Bilddaten als auch sprachliche Informationen zu verarbeiten und miteinander zu verknüpfen.

