
Warum der Abruf das Nadelöhr für die faktische Genauigkeit generativer KI-Modelle darstellt
Ein aktueller Bericht von Google Research untersucht die Herausforderungen der parametrischen Faktentreue in der generativen KI. Unter dem Titel „Empty shelves or lost keys?“ wird analysiert, ob KI-Modelle Fakten grundsätzlich nicht speichern oder lediglich nicht korrekt abrufen können. Die zentrale Erkenntnis der Untersuchung ist, dass der Abruf (Recall) das entscheidende Nadelöhr für die faktische Korrektheit darstellt. Dies bedeutet, dass Informationen oft zwar in den Parametern des Modells vorhanden sind, aber im entscheidenden Moment nicht erfolgreich aktiviert werden können. Diese Unterscheidung zwischen Wissen und Abrufkapazität ist fundamental für das Verständnis, wie generative KI-Systeme verbessert werden können, um Halluzinationen zu reduzieren und die Verlässlichkeit von Antworten zu steigern.
Die wichtigsten Punkte
- Recall als zentraler Engpass: Der Abruf von Informationen ist das primäre Hindernis für die faktische Genauigkeit in der generativen KI.
- Parametrische Faktentreue: Die Untersuchung konzentriert sich auf Wissen, das direkt in den Parametern des Modells gespeichert ist.
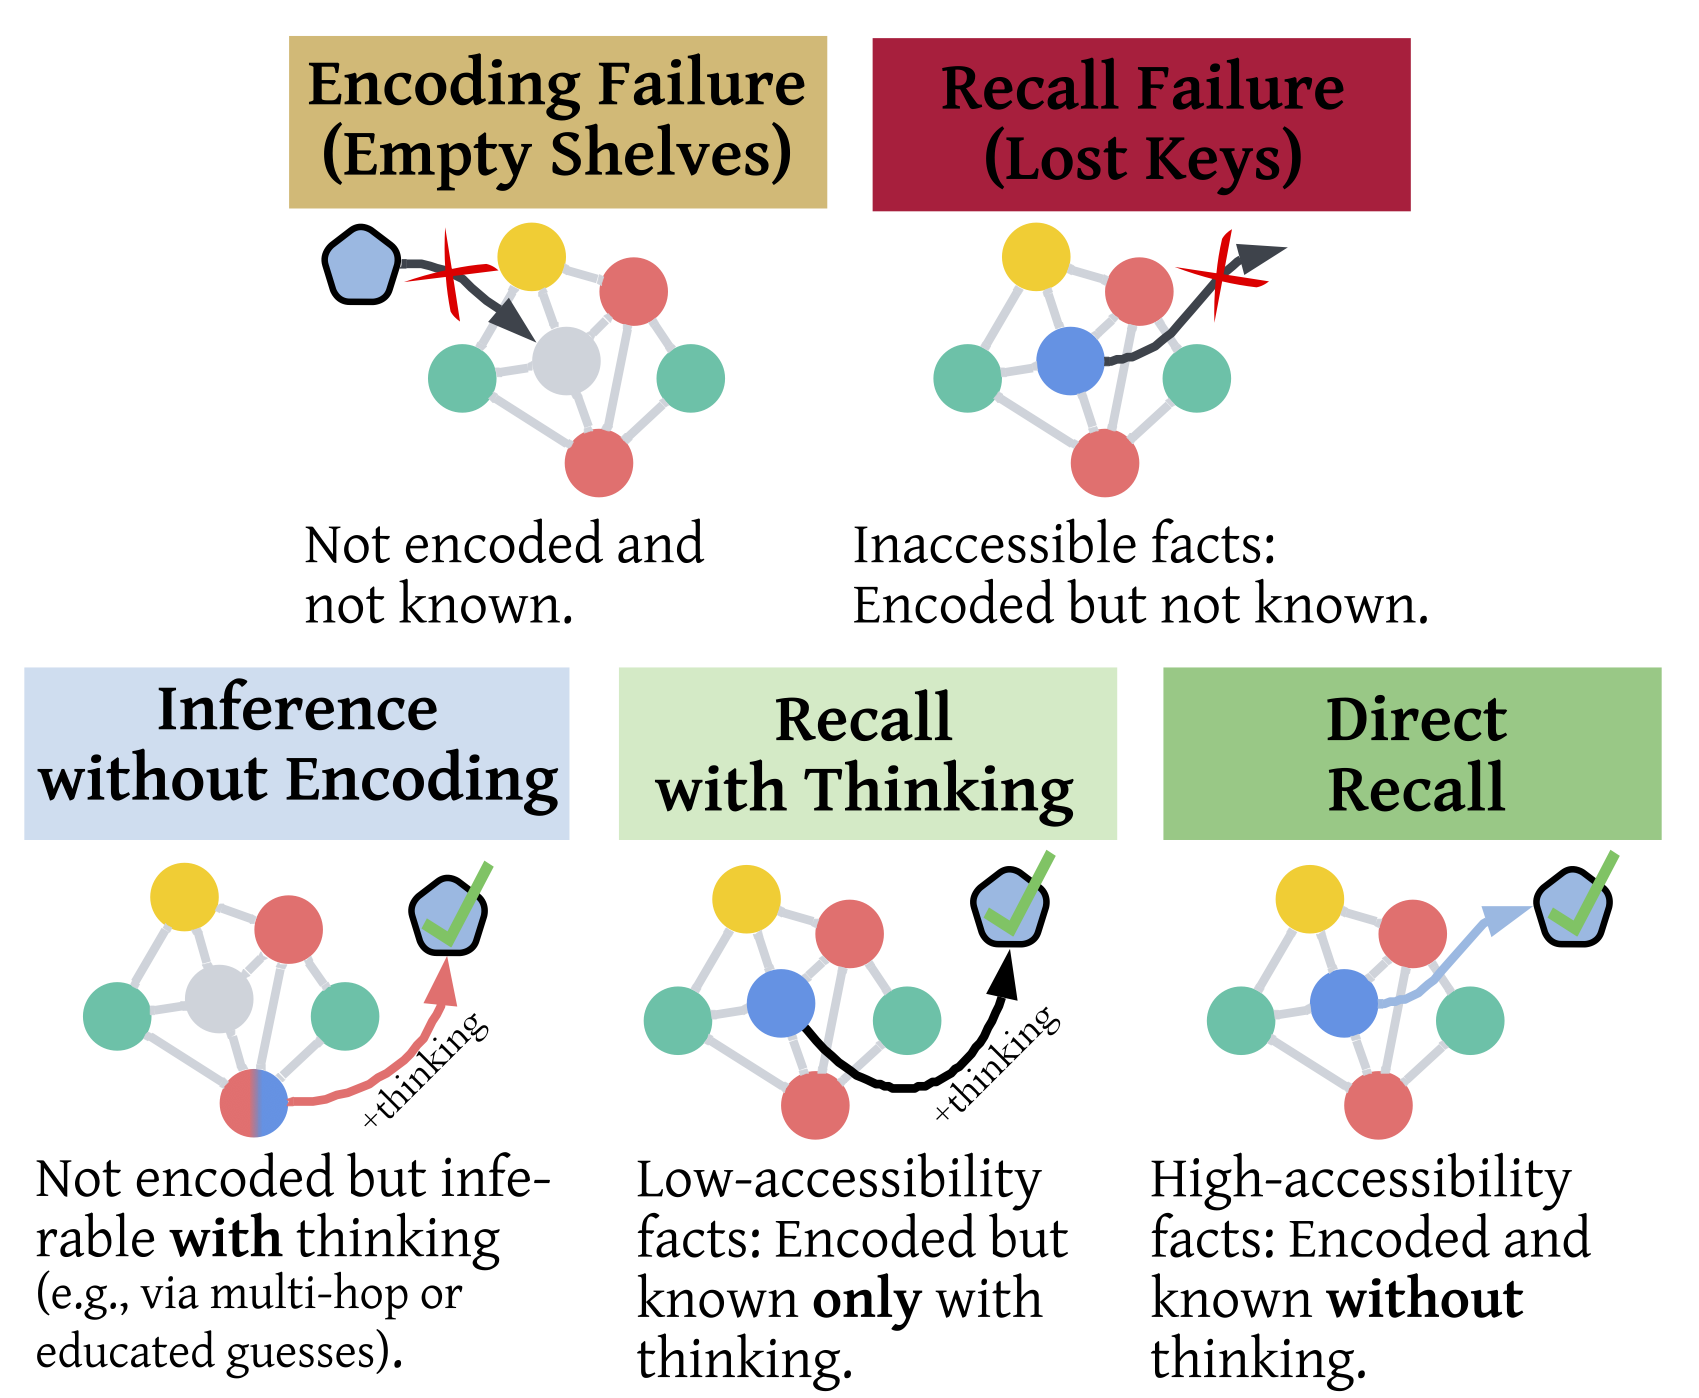
- Metapher der Wissensspeicherung: Das Problem wird als Unterscheidung zwischen „leeren Regalen“ (fehlendes Wissen) und „verlorenen Schlüsseln“ (fehlender Zugriff) beschrieben.
- Fokus auf Generative AI: Die Analyse bezieht sich spezifisch auf die Funktionsweise moderner generativer KI-Systeme.
Analyse
Parametrische Faktentreue und das Recall-Problem
In der Entwicklung von Systemen der generativen KI spielt die sogenannte parametrische Faktentreue eine entscheidende Rolle. Diese beschreibt die Fähigkeit eines Modells, Fakten allein aus den während des Trainings erlernten Gewichten – den Parametern – korrekt wiederzugeben. Google Research identifiziert hierbei ein spezifisches Problem: den Recall-Bottleneck.
Die Forschung deutet darauf hin, dass die bloße Skalierung von Modellen oder die Erhöhung der Datenmenge nicht zwangsläufig zu einer proportionalen Steigerung der Faktentreue führt, wenn der Mechanismus des Abrufs nicht gleichermaßen optimiert wird. Der Abruf fungiert hierbei als Filter oder Nadelöhr. Selbst wenn ein Modell während der Trainingsphase mit korrekten Informationen gespeist wurde, garantiert dies nicht, dass diese Informationen in einer konkreten Abfragesituation auch korrekt „recalled“, also abgerufen, werden können.
Die Metapher: Leere Regale vs. Verlorene Schlüssel
Um die Komplexität der parametrischen Faktentreue zu verdeutlichen, nutzt Google Research eine eingängige Metapher: „Empty shelves or lost keys?“ (Leere Regale oder verlorene Schlüssel?).
-
Leere Regale (Empty Shelves): Dies stünde für ein Szenario, in dem das Modell eine Information niemals gelernt hat. Das Wissen ist physisch nicht in den Parametern vorhanden. In diesem Fall kann das Modell die Frage nicht korrekt beantworten, weil die „Regale“ des Speichers leer sind.
-
Verlorene Schlüssel (Lost Keys): Hierbei ist die Information zwar im Modell vorhanden – sie liegt im „Regal“ –, aber das Modell findet den Zugang dazu nicht. Der „Schlüssel“ zum Schloss des Wissensspeichers fehlt oder funktioniert nicht korrekt.
Die Schlussfolgerung, dass der Recall das Nadelöhr ist, legt nahe, dass wir es in der aktuellen Phase der KI-Entwicklung häufiger mit „verlorenen Schlüsseln“ als mit „leeren Regalen“ zu tun haben. Das Modell besitzt das Wissen theoretisch, scheitert aber an der praktischen Extraktion zum Zeitpunkt der Generierung.
Bedeutung für die KI-Branche
Die Erkenntnis, dass der Abruf der limitierende Faktor für die Faktentreue ist, hat weitreichende Konsequenzen für die Branche der generativen KI. Bisher lag ein massiver Fokus darauf, Modelle mit immer größeren Datensätzen zu trainieren, um das interne Wissen zu maximieren. Wenn jedoch der Abruf das eigentliche Problem darstellt, verschiebt sich der Fokus der Forschung.
Unternehmen und Forscher müssen verstärkt Mechanismen entwickeln, die den internen Zugriff auf bereits gelerntes Wissen verbessern. Dies könnte die Art und Weise verändern, wie Architekturen für generative KI entworfen werden. Anstatt nur die Kapazität (die Anzahl der Regale) zu erhöhen, muss die Effizienz der Adressierung (die Qualität der Schlüssel) gesteigert werden. Für die Praxis bedeutet dies, dass die Reduzierung von KI-Halluzinationen weniger eine Frage der Datenmenge, sondern vielmehr eine Frage der präzisen Informationsrückgewinnung aus den Modellparametern ist.
Häufig gestellte Fragen
Was ist der Unterschied zwischen parametrischer Faktentreue und externem Wissen?
Parametrische Faktentreue bezieht sich auf das Wissen, das fest in den Gewichten (Parametern) eines KI-Modells gespeichert ist. Im Gegensatz dazu steht die Nutzung externer Quellen, wie etwa bei der Retrieval-Augmented Generation (RAG), wo das Modell während der Antwortgenerierung auf externe Datenbanken oder das Internet zugreift.
Warum wird der Recall als „Nadelöhr“ bezeichnet?
Der Begriff Nadelöhr (Bottleneck) wird verwendet, weil die Gesamtleistung des Systems in Bezug auf die Wahrheitstreue durch den Abruf begrenzt wird. Selbst wenn alle anderen Teile des Modells perfekt funktionieren und das Wissen vorhanden ist, verhindert ein schwacher Recall, dass die korrekte Information den Nutzer erreicht.
Was bedeutet die Metapher der „verlorenen Schlüssel“ für die Zukunft der KI?
Sie bedeutet, dass die Forschung sich stärker darauf konzentrieren wird, wie Modelle ihre eigenen internen Informationen besser organisieren und finden können. Es geht also um die Optimierung der internen Such- und Aktivierungsprozesse innerhalb der neuronalen Netze, um vorhandenes Wissen effektiver nutzbar zu machen.

