
Microsoft Research präsentiert CARE-X: Ein Framework für klinisch nutzbare radiologische Vision-Language-Modelle
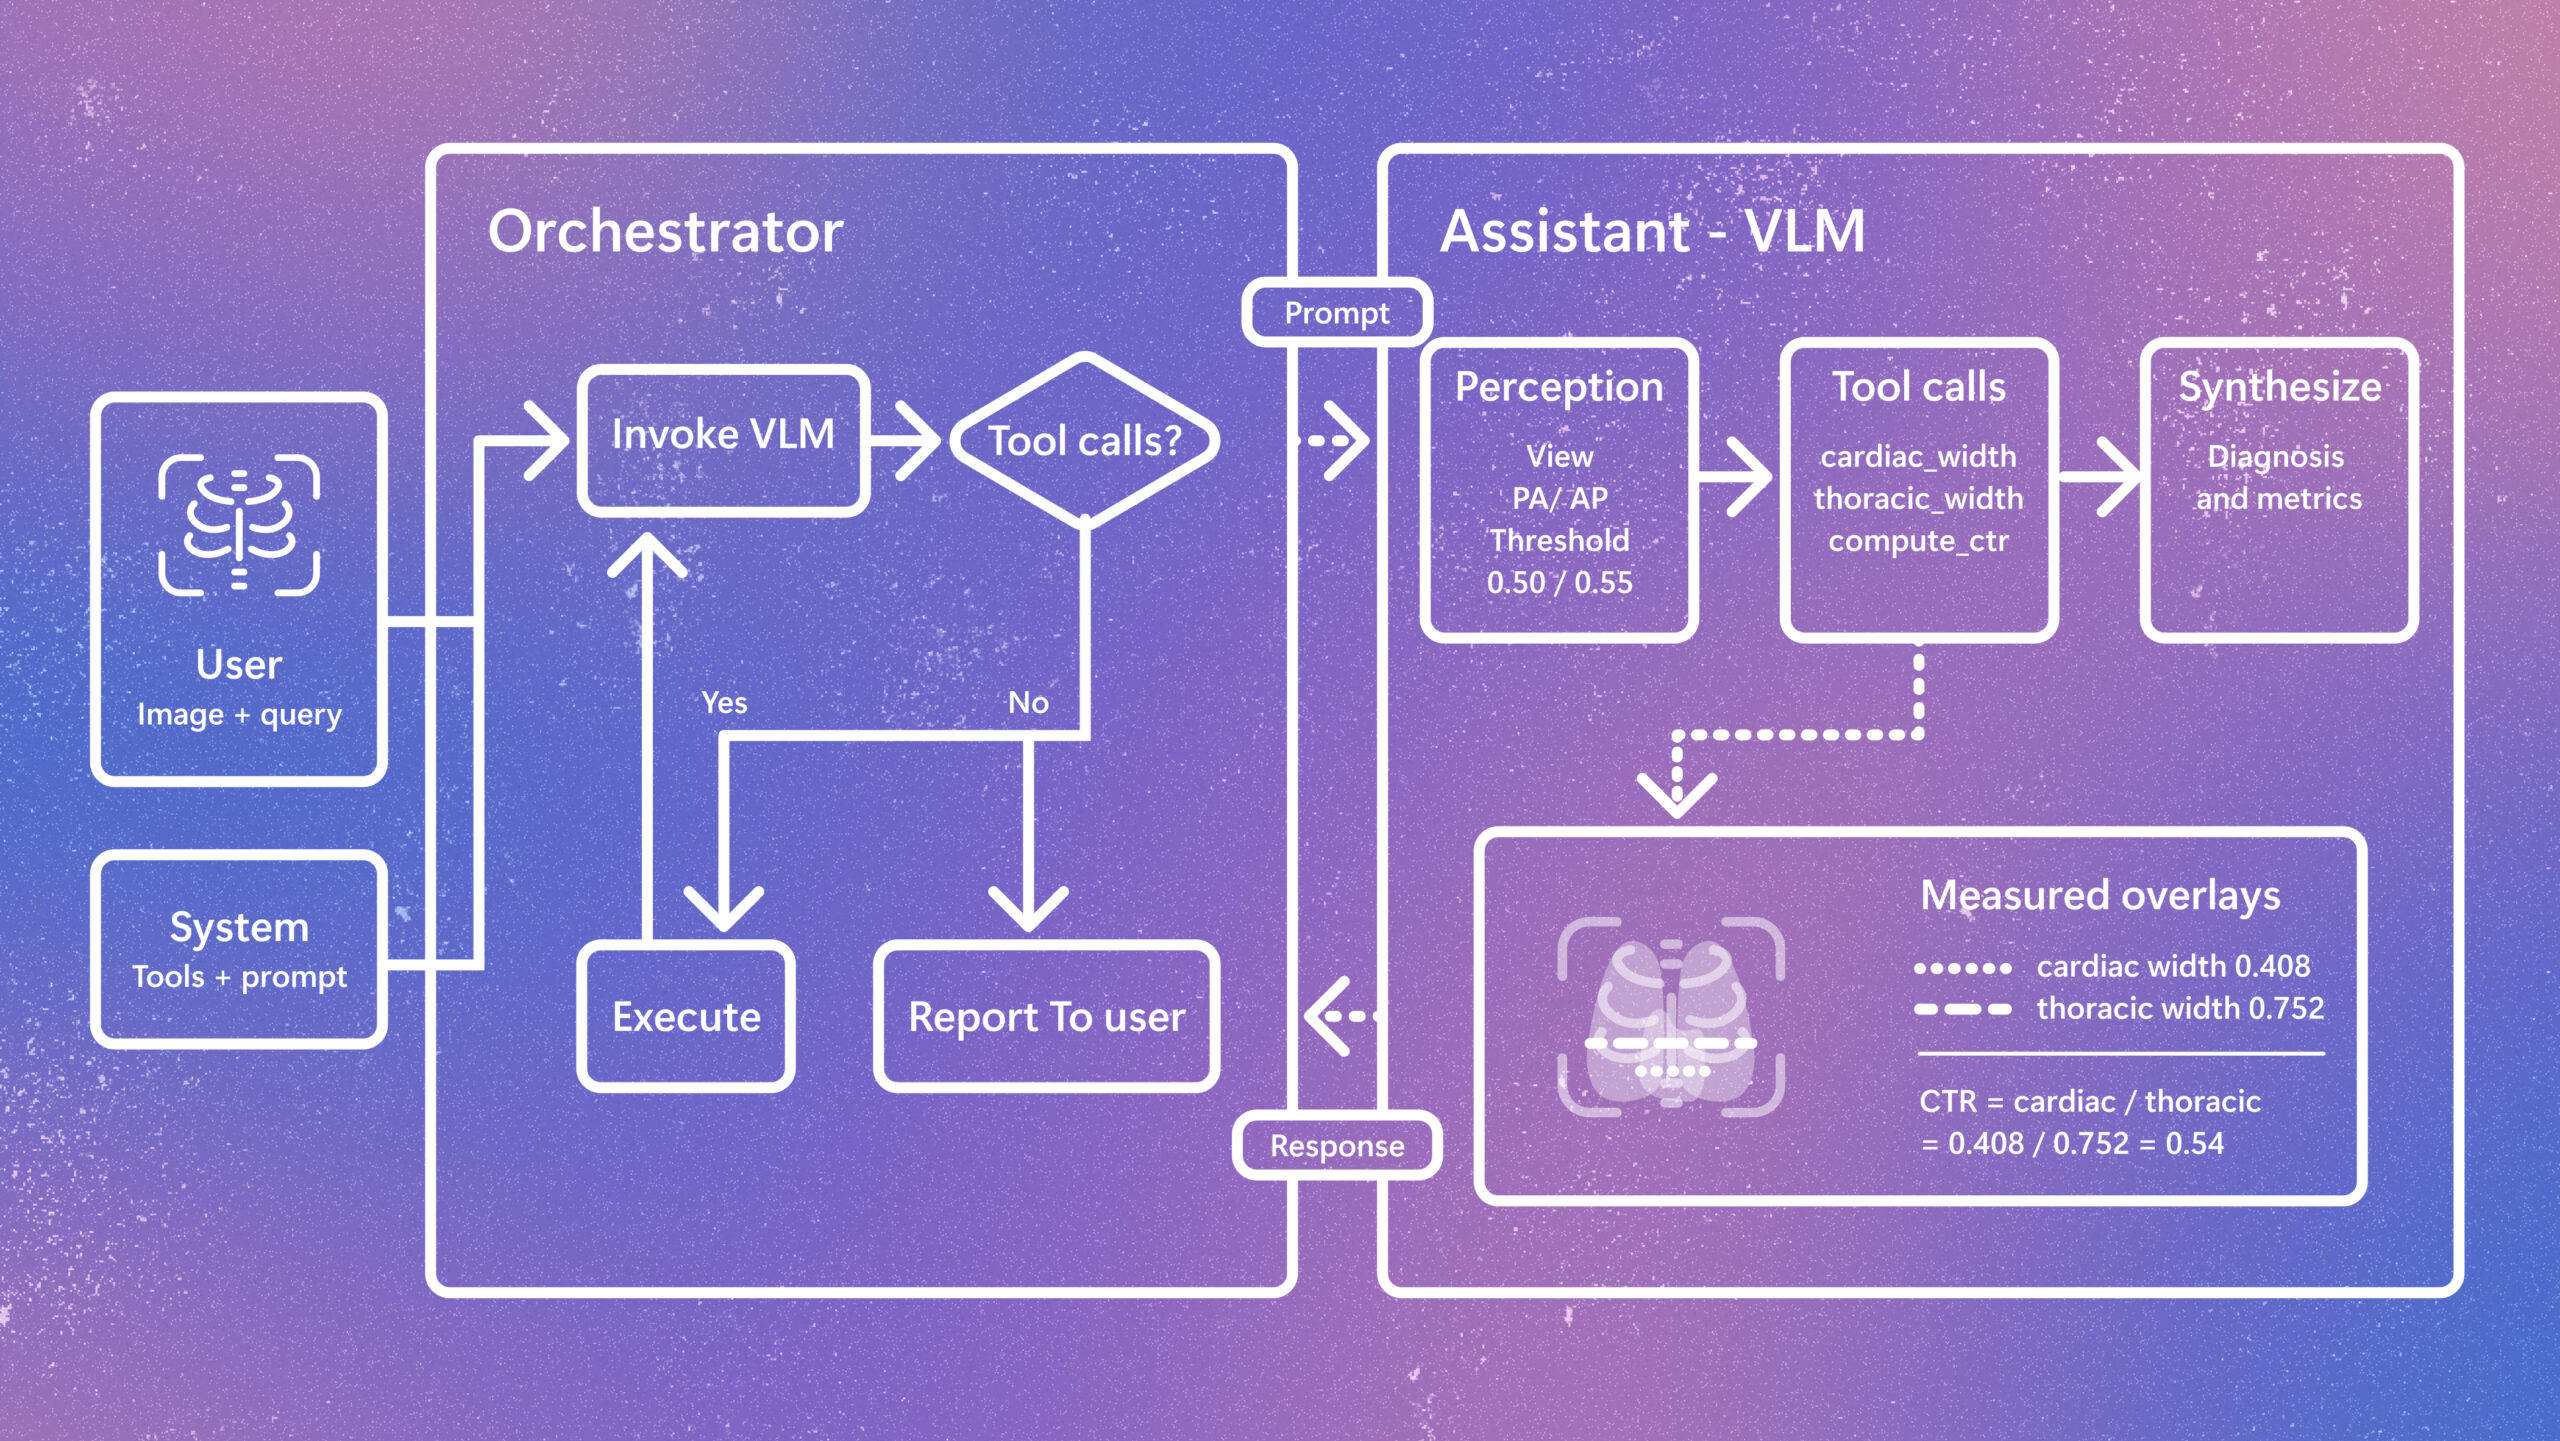
Microsoft Research hat CARE-X vorgestellt, ein innovatives Framework, das die klinische Anwendbarkeit von Vision-Language-Modellen (VLMs) in der Radiologie verbessern soll. Da herkömmliche KI-Modelle in der medizinischen Bildgebung oft Schwierigkeiten haben, klinisch relevante Anforderungen zu erfüllen, setzt CARE-X auf drei zentrale Säulen: Hilfsüberwachung (Auxiliary Supervision), belohnungsorientiertes Lernen (Reward-Aligned Learning) und werkzeuggestützte Messungen (Tool-Augmented Measurement). Diese methodischen Ansätze zielen darauf ab, die Präzision und Verlässlichkeit von KI-gestützten Diagnosen zu erhöhen. Entwickelt von einem Team um Mercy Ranjit und Dr. Abhyuday Kumara Swamy, markiert CARE-X einen wichtigen Schritt hin zu einer tieferen Integration von KI in den radiologischen Workflow, indem es die Lücke zwischen theoretischer Modellleistung und praktischem klinischem Nutzen schließt.
Die wichtigsten Punkte
- Einführung von CARE-X: Ein neues Framework von Microsoft Research zur Entwicklung klinisch nutzbarer Vision-Language-Modelle (VLMs) speziell für die Radiologie.
- Drei-Säulen-Ansatz: Das System basiert auf Hilfsüberwachung (Auxiliary Supervision), belohnungsorientiertem Lernen (Reward-Aligned Learning) und werkzeuggestützten Messungen (Tool-Augmented Measurement).
- Klinische Relevanz: Der Fokus liegt auf der Transformation von Standard-VLMs in Werkzeuge, die den spezifischen Anforderungen und Genauigkeitsstandards der klinischen Praxis entsprechen.
- Expertenteam: Die Entwicklung wurde von Forschenden wie Mercy Ranjit, Nikhilesh E, Dr. Abhyuday Kumara Swamy und Tanuja Ganu geleitet.
Analyse der CARE-X Methodik
Hilfsüberwachung und belohnungsorientiertes Lernen
Der Kern von CARE-X liegt in der Verbesserung der Art und Weise, wie Vision-Language-Modelle trainiert und bewertet werden. Die Auxiliary Supervision (Hilfsüberwachung) dient dazu, dem Modell zusätzliche Informationen oder Signale während des Lernprozesses zur Verfügung zu stellen, die über die einfache Bild-Text-Zuordnung hinausgehen. Dies ist in der Radiologie von entscheidender Bedeutung, da rein visuelle Daten oft durch medizinisches Fachwissen ergänzt werden müssen, um korrekt interpretiert zu werden.
Ergänzt wird dies durch Reward-Aligned Learning (belohnungsorientiertes Lernen). Dieser Ansatz deutet darauf hin, dass das Modell darauf optimiert wird, Ergebnisse zu liefern, die mit klinischen Prioritäten übereinstimmen. Anstatt nur statistische Wahrscheinlichkeiten von Wortfolgen zu minimieren, wird das Modell darauf ausgerichtet, Antworten zu generieren, die in einem medizinischen Kontext als „wertvoll“ oder „korrekt“ eingestuft werden.
Werkzeuggestützte Messung für klinische Präzision
Ein wesentliches Unterscheidungsmerkmal von CARE-X ist das Tool-Augmented Measurement (werkzeuggestützte Messung). In der Radiologie reicht eine qualitative Beschreibung eines Bildes oft nicht aus; quantitative Daten und präzise Messungen sind für die Diagnose unerlässlich. Durch die Integration von Werkzeugen in den Messprozess kann CARE-X potenziell objektivere und reproduzierbare Daten liefern, die über die rein generative Kapazität herkömmlicher VLMs hinausgehen. Dies adressiert eines der Hauptprobleme bei der Nutzung von KI in der Medizin: die Notwendigkeit von Exaktheit gegenüber vagen Beschreibungen.
Bedeutung für die KI-Branche
Die Vorstellung von CARE-X durch Microsoft Research unterstreicht den Trend weg von allgemeinen KI-Modellen hin zu hochspezialisierten, klinisch validierten Systemen. Für die KI-Branche bedeutet dies eine Verschiebung des Fokus: Es geht nicht mehr nur um die Größe der Modelle (Parameteranzahl), sondern um deren Alignment mit spezifischen Fachdomänen.
Indem Microsoft Techniken wie Reward-Aligned Learning auf die Medizin anwendet, setzt das Unternehmen neue Maßstäbe für die Sicherheit und Nützlichkeit von KI. CARE-X könnte als Blaupause für andere hochregulierte Bereiche dienen, in denen Fehler fatale Folgen haben können und in denen eine rein generative KI ohne zusätzliche Überwachungs- und Messmechanismen nicht ausreicht.
Häufig gestellte Fragen
Was unterscheidet CARE-X von herkömmlichen Vision-Language-Modellen?
Während Standard-VLMs darauf trainiert sind, allgemeine Zusammenhänge zwischen Bildern und Texten zu verstehen, ist CARE-X speziell durch Hilfsüberwachung und werkzeuggestützte Messungen auf die hohen Genauigkeitsanforderungen der Radiologie optimiert.
Wer hat CARE-X entwickelt?
Das Framework wurde von einem Forschungsteam bei Microsoft Research entwickelt, bestehend aus Mercy Ranjit, Nikhilesh E, Dr. Abhyuday Kumara Swamy und Tanuja Ganu.
Warum ist „Reward-Aligned Learning“ in der Medizin wichtig?
In der Medizin sind nicht alle Fehler gleich gewichtet. Belohnungsorientiertes Lernen ermöglicht es, das Modell so zu trainieren, dass es klinisch relevante Fakten priorisiert und Ausgaben vermeidet, die medizinisch irreführend oder riskant wären.

