
Zurück zur Übersicht
Token Pooling-Aware Training für Multi-Vector Embedding Modelle im Hugging Face Blog
ForschungsdurchbruchHugging FaceEmbeddingsMachine Learning

Token Pooling-Aware Training für Multi-Vector Embedding Modelle im Hugging Face Blog

Der Artikel mit dem Titel „Token Pooling-Aware Training for Multi-Vector Embedding Models“ wurde am 11. November 2026 im Hugging Face Blog veröffentlicht. Die Autorenschaft wird vom Hugging Face Blog angegeben. Da im Original keine weiteren inhaltlichen Details vorliegen, beschränkt sich dieser Bericht auf die grundlegenden Veröffentlichungsdaten dieses Beitrags zur Optimierung von Multi-Vector Embedding Modellen und tokenbasierten Verfahren im Bereich der künstlichen Intelligenz.

Hugging Face Blog

Die wichtigsten Punkte

  • Veröffentlichung des Artikels „Token Pooling-Aware Training for Multi-Vector Embedding Models“ auf dem offiziellen Hugging Face Blog.
  • Das Erscheinungsdatum der Originalmeldung ist der 11. November 2026.
  • Als Autor bzw. Herausgeber ist der Hugging Face Blog angegeben.
  • Der Beitrag thematisiert Verfahren rund um Multi-Vector Embedding Modelle und Token Pooling-Aware Training.

Analyse

Hintergrund der Veröffentlichung

Die Veröffentlichung erschien am 11. November 2026 im Hugging Face Blog unter dem Titel „Token Pooling-Aware Training for Multi-Vector Embedding Models“. In der KI-Forschung spielen Multi-Vector Embedding Modelle eine wichtige Rolle, um komplexe Texte und Datenstrukturen präzise abzubilden. Der Blogbeitrag widmet sich diesem Themengebiet und beleuchtet spezifische Trainingsmethoden im Zusammenhang mit Token Pooling.

Inhaltlicher Rahmen

Da die Originalmeldung abgesehen von Titel, Veröffentlichungsdatum, Quelle und Autor keine weiteren textlichen Details oder Code-Beispiele enthält, lässt sich zum genauen technischen Aufbau oder zu Leistungswerten keine Aussage treffen. Der Fokus der Meldung liegt rein auf der Ankündigung beziehungsweise Bereitstellung des Beitrags auf der Plattform von Hugging Face.

Bedeutung für die KI-Branche

Veröffentlichungen im Hugging Face Blog dienen häufig dazu, neue methodische Ansätze, Modelle oder Trainingsstrategien aus der KI-Forschung der Community zugänglich zu machen. Das Thema Multi-Vector Embedding Modelle und Token Pooling-Aware Training berührt wichtige Aspekte der modernen Vektorsuche und des Information Retrieval, wodurch entsprechende Fachartikel für Entwickler und Forscher von Interesse sind.

Häufig gestellte Fragen

Wann wurde der Artikel veröffentlicht?

Der Artikel wurde am 11. November 2026 im Hugging Face Blog veröffentlicht.

Wer ist der Autor des Beitrags?

Als Autor und Quelle ist der Hugging Face Blog angegeben.
Ähnliche Nachrichten

Nutzung von Wearables zur Ermittlung des kardiovaskulären-renalen-metabolischen (CKM) Risikoprofils für personalisiertes Coaching
Forschungsdurchbruch

Nutzung von Wearables zur Ermittlung des kardiovaskulären-renalen-metabolischen (CKM) Risikoprofils für personalisiertes Coaching

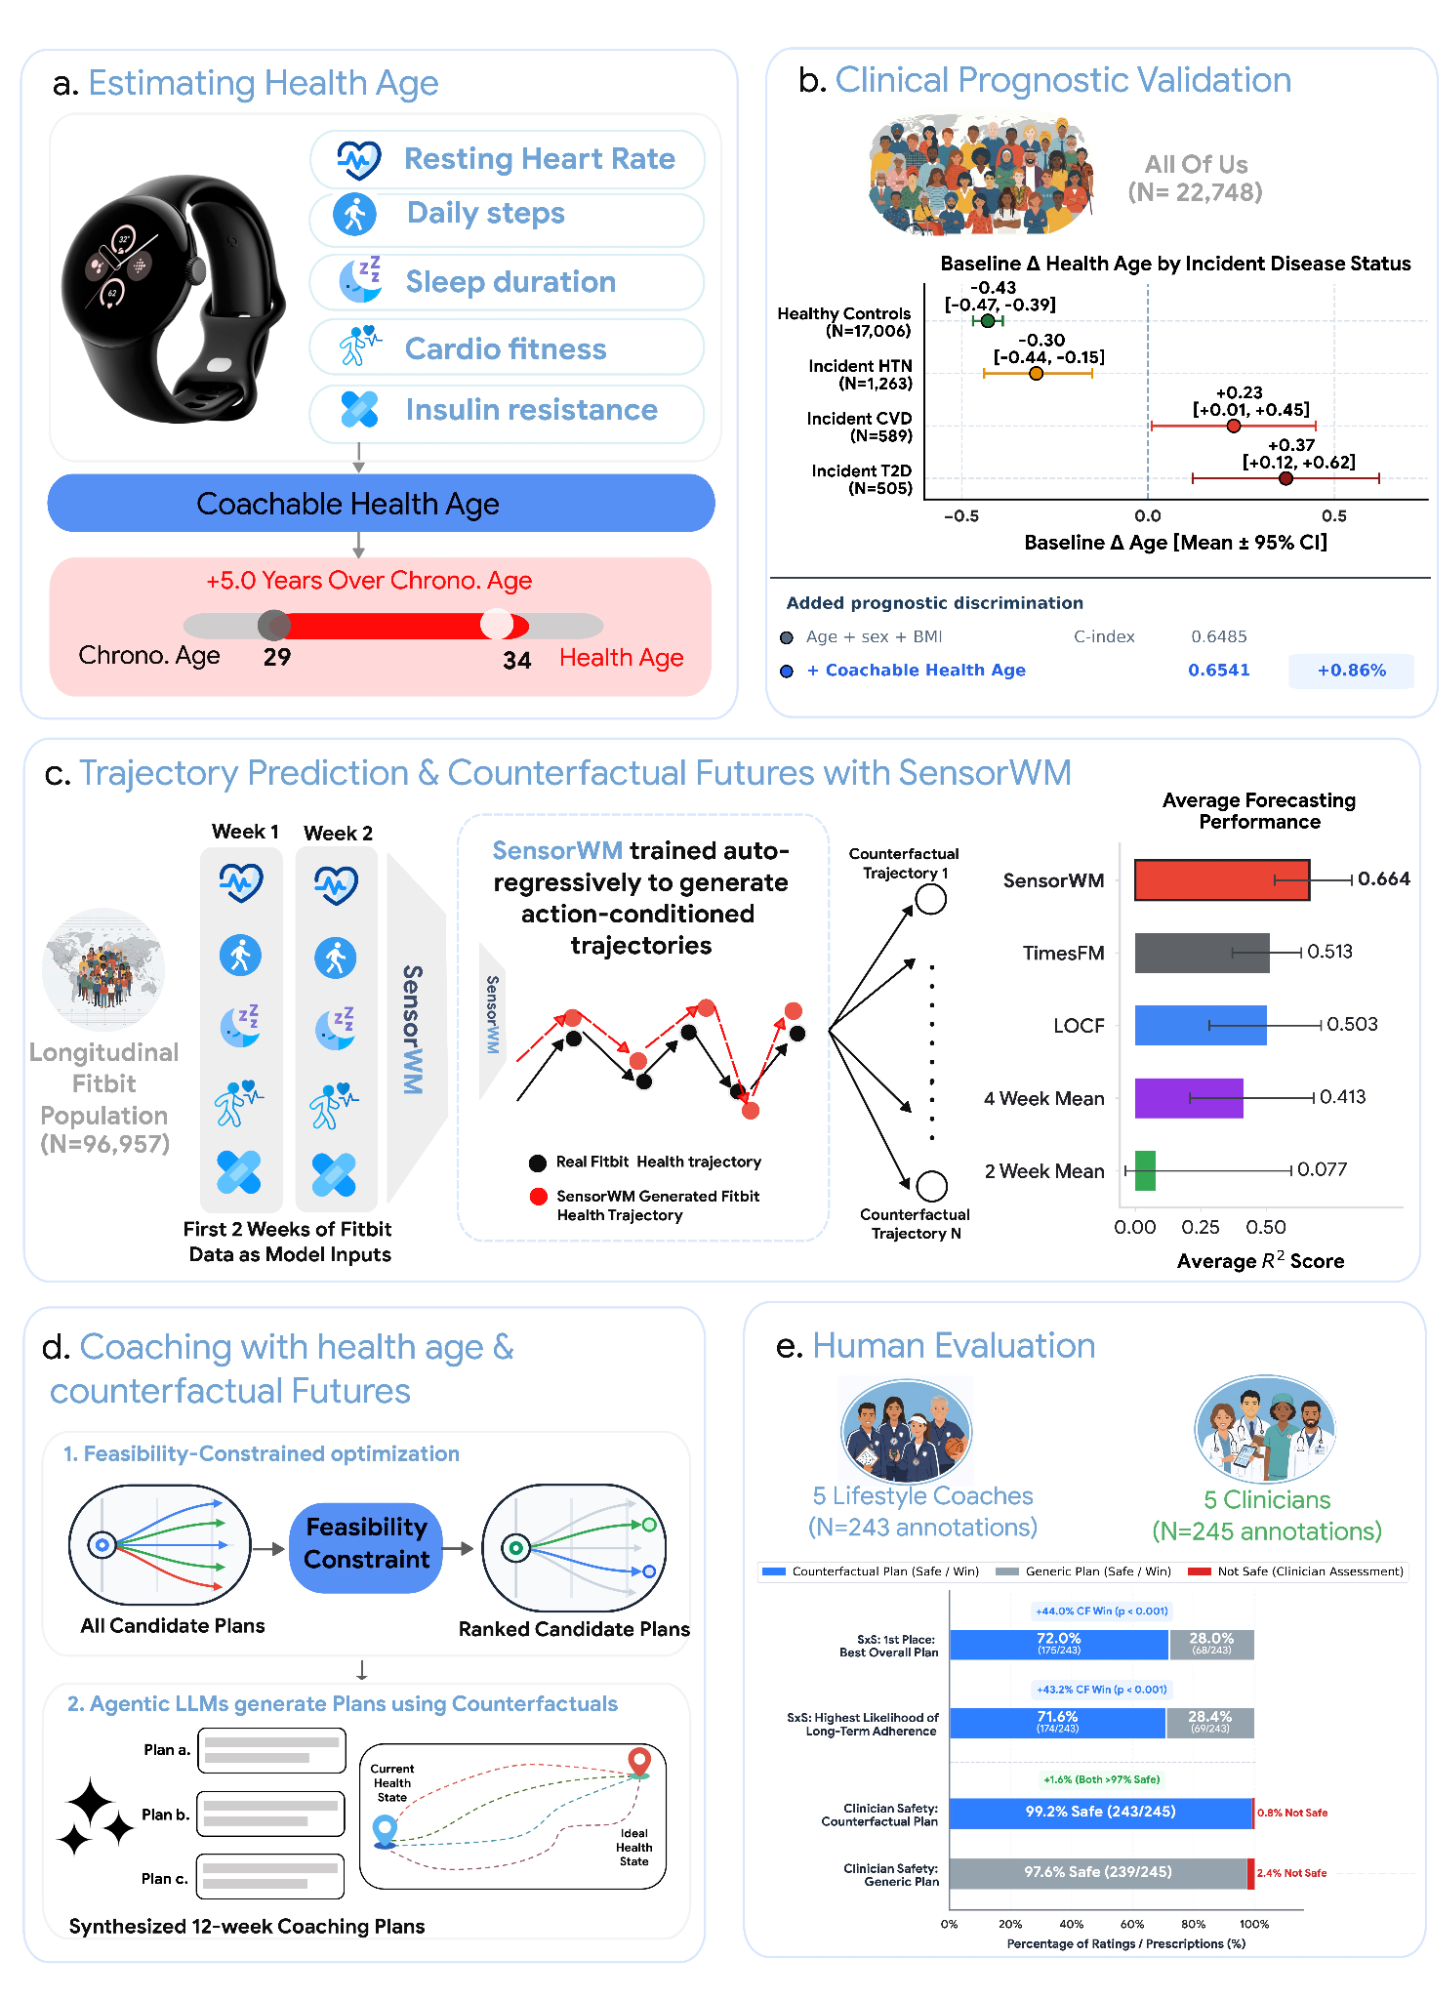
Google Research stellt einen untersuchten Rahmen für maschinelles Lernen vor, der passive Wearable-Signale in ein modifizierbares, coachtaugliches Gesundheitsalter übersetzt. Das System nutzt ein aktionskonditioniertes Weltmodell, um personalisierte 12-Wochen-„Was-wäre-wenn“-Gewohnheitstrajektorien zu simulieren, und erweitert dies um routinemäßige Blutbiomarker, um die frühe kardiovaskuläre-renale-metabolisches (CKM) Gesundheit zu verfolgen. Herzerkrankungen, Nierenleiden und Stoffwechselstörungen wie Typ-2-Diabetes bilden ein vernetztes CKM-Syndrom, dessen schleichende Progression oft Jahre vor dem Auftreten von Symptomen beginnt und durch alltägliche Gewohnheiten beeinflusst wird.

AlphaGenome 2 von DeepMind: Entschlüsselung des DNA-Leseverhaltens von Zellen zum besseren Krankheitsverständnis
Forschungsdurchbruch

AlphaGenome 2 von DeepMind: Entschlüsselung des DNA-Leseverhaltens von Zellen zum besseren Krankheitsverständnis

DeepMind hat AlphaGenome 2 vorgestellt, ein System zur Vorhersage, wie DNA-Sequenzen und deren Variationen spezifische menschliche Zelltypen und Krankheiten beeinflussen. Die Veröffentlichung beleuchtet, wie das Modell dabei hilft zu verstehen, wie Zellen DNA lesen, um ein besseres Verständnis von Krankheiten zu ermöglichen. Der Beitrag fasst die wesentlichen Aspekte dieser Entwicklung zusammen, die darauf abzielt, die Auswirkungen genetischer Variationen auf molekularer Ebene zu analysieren.

Google DeepMind stellt AlphaGenome 2 vor: Neues KI-Modell zur Untersuchung genetischer Krankheitsursachen
Forschungsdurchbruch

Google DeepMind stellt AlphaGenome 2 vor: Neues KI-Modell zur Untersuchung genetischer Krankheitsursachen

Forscher von Google DeepMind haben das neue KI-Modell AlphaGenome 2 vorgestellt. Die Technologie wurde entwickelt, um zu analysieren, wie sich Veränderungen in unserer DNA auf verschiedene Zellen auswirken. Damit erhalten Wissenschaftler einen detaillierteren Einblick in ein äußerst komplexes Problem, das wichtige Hinweise auf die Ursachen von Krankheiten liefern und den Weg zu neuen Behandlungen aufzeigen könnte. AlphaGenome 2 ist der Nachfolger eines früheren Systems.