5 Techniken zum kostengünstigen Fine-Tuning von LLMs ohne hohes Budget
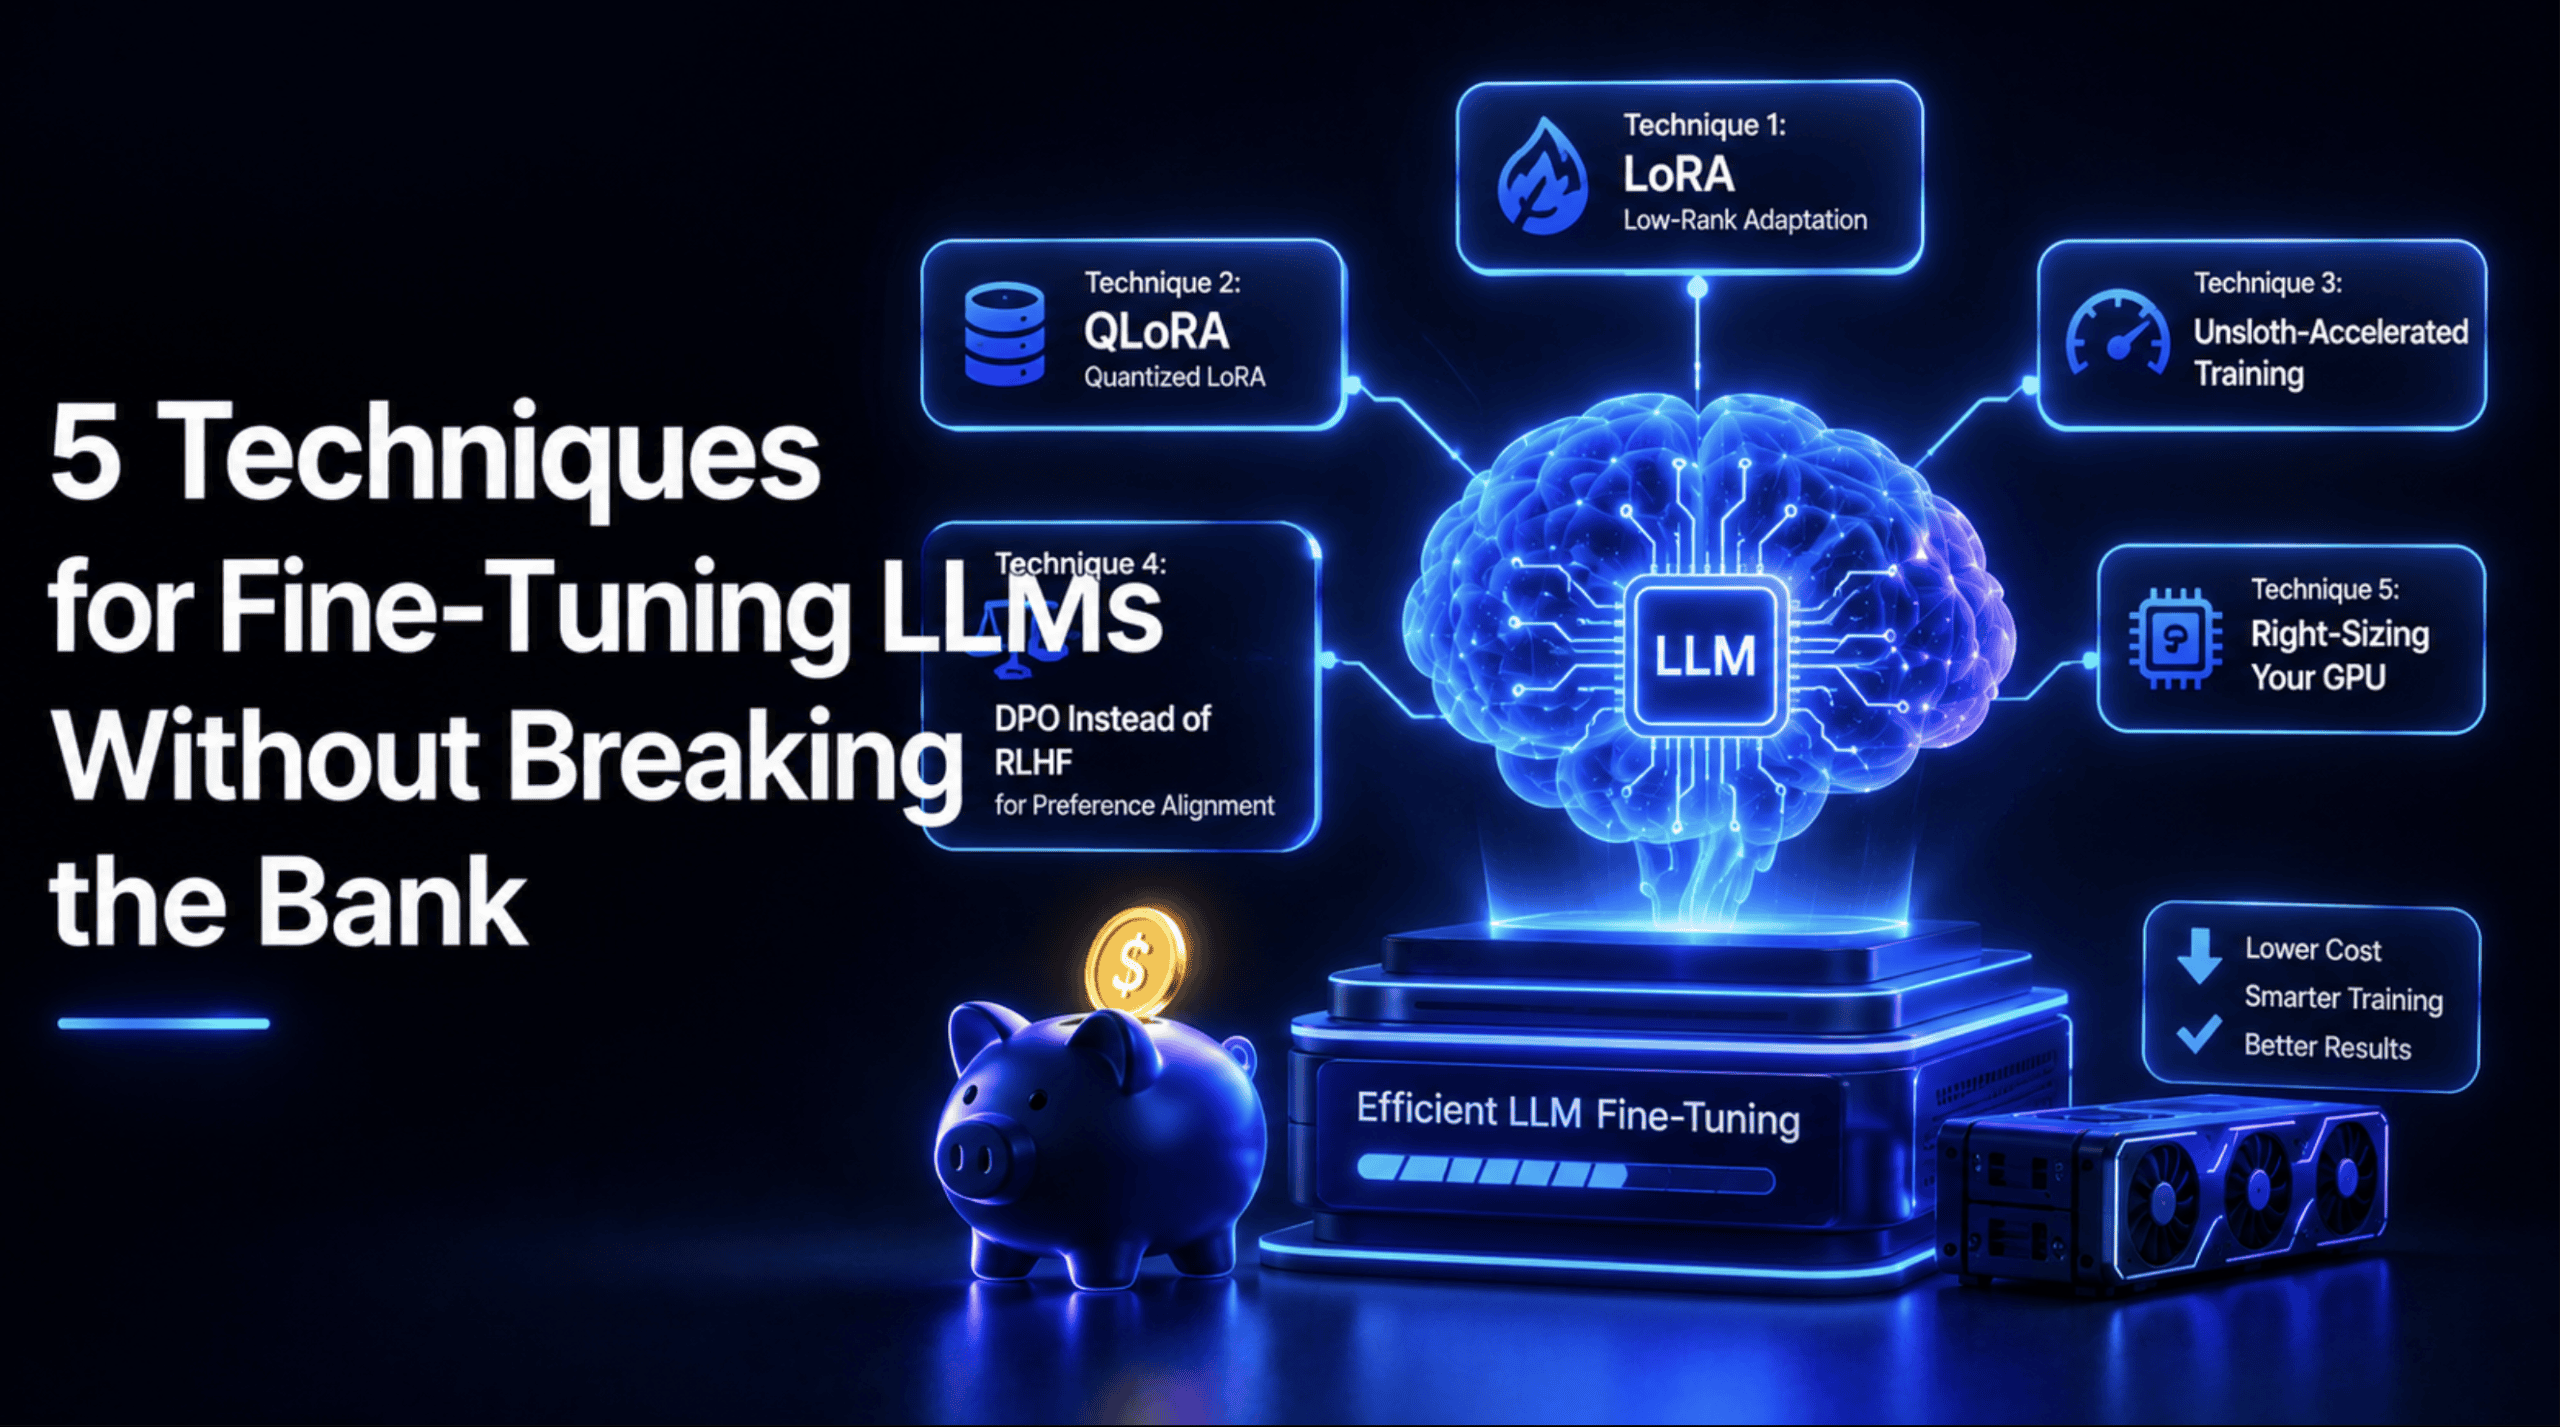
Das Fine-Tuning von großen Sprachmodellen (LLMs) gilt häufig als teure und aufwendige Forschungsaktivität, doch die Anpassung bestehender Open-Weight-Modelle an spezifische Aufgaben ist heute in einer völlig anderen Kostenkategorie möglich. Ein technischer Leitfaden beleuchtet fünf praxisnahe und kosteneffiziente Methoden für das Fine-Tuning von LLMs mit begrenztem Budget. Die vorgestellten Ansätze umfassen parametereffiziente Verfahren wie LoRA (Low-Rank Adaptation) und QLoRA (Quantized Low-Rank Adaptation) sowie schnellere Trainings-Tools (Unsloth), kostengünstigere Ausrichtungsziele (DPO) und die richtige Dimensionierung der GPU-Infrastruktur. Für jede dieser fünf Techniken wird zudem funktionierender Code bereitgestellt, um Entwicklern und Unternehmen die praktische Umsetzung zu erleichtern.
Die wichtigsten Punkte
- Vorstellung von fünf praxisnahen Wegen zum kostengünstigen Fine-Tuning von LLMs mit begrenztem Budget.
- Einbezug parametereffizienter Methoden wie LoRA und QLoRA.
- Nutzung schnellerer Trainings-Tools (Unsloth) und kostengünstigerer Ausrichtungsziele wie DPO (Direct Preference Optimization).
- Optimierung der Infrastruktur durch das richtige In-Size- bzw. Right-Sizing der GPU.
- Bereitstellung von funktionierendem Programmcode für jede einzelne Technik.
Analyse
Praktische Wege zum budgetfreundlichen Fine-Tuning
Das Fine-Tuning von großen Sprachmodellen wird traditionell oft mit enormen Kosten und dem exklusiven Zugriff auf hochentwickelte Forschungs-Labore assoziiert. Für das vollständige Fine-Tuning von Frontier-Modellen von Grund auf trifft dieser Ruf zu, da solche Trainingsläufe extrem teuer sein können. Die Anpassung eines bestehenden Open-Weight-Modells an einen spezifischen Anwendungsbereich bewegt sich jedoch in einer völlig anderen Kostenkategorie. Der Leitfaden bietet hierfür fünf konkrete Techniken an, die einen Betrieb auf schmalem Budget ermöglichen, und liefert jeweils echten, ausführbaren Code dazu.
Überblick über die fünf Techniken
Die im Beitrag behandelten Methoden decken verschiedene Aspekte der Kostensenkung und Effizienzsteigerung ab. Dazu gehören parameter-effiziente Ansätze wie Low-Rank Adaptation (LoRA) und Quantized Low-Rank Adaptation (QLoRA), die den Speicher- und Rechenbedarf drastisch reduzieren. Ergänzt wird dies durch Tools für schnellere Trainingsprozesse wie Unsloth sowie effizientere Ausrichtungsziele (Alignment Objectives) wie DPO. Ein oft unterschätzter Faktor, der die Rechnungen in die Höhe treibt, sind zudem Infrastruktur-Entscheidungen, weshalb auch das „Right-Sizing“ der verwendeten Grafikprozessoren (GPUs) einen zentralen Schwerpunkt bildet.
Bedeutung für die KI-Branche
Die Möglichkeit, große Sprachmodelle mit überschaubarem finanziellem Aufwand und geringerem Rechenaufwand anzupassen, demokratisiert den Zugang zu maßgeschneiderter künstlicher Intelligenz. Durch den Einsatz von Techniken wie LoRA, QLoRA, Unsloth und DPO in Kombination mit einer optimierten GPU-Infrastruktur können auch kleinere Organisationen und Entwickler spezialisierte Modelle entwickeln, ohne durch astronomische Cloud- oder Hardware-Kosten eingeschränkt zu werden.
Häufig gestellte Fragen
Welche Techniken werden für das kostengünstige Fine-Tuning von LLMs vorgestellt?
Der Leitfaden deckt fünf Methoden ab: LoRA (Low-Rank Adaptation), QLoRA (Quantized Low-Rank Adaptation), Unsloth für schnelleres Training, DPO (Direct Preference Optimization) für das Alignment sowie das Right-Sizing der GPU-Infrastruktur.
Wird für die Techniken praktischer Programmcode bereitgestellt?
Ja, für jede der fünf vorgestellten Techniken wird in der Originalmeldung funktionierender Code bereitgestellt.