LLM Wiki von nashsu transformiert Dokumente in persistente und vernetzte Wissensdatenbanken als Alternative zu RAG
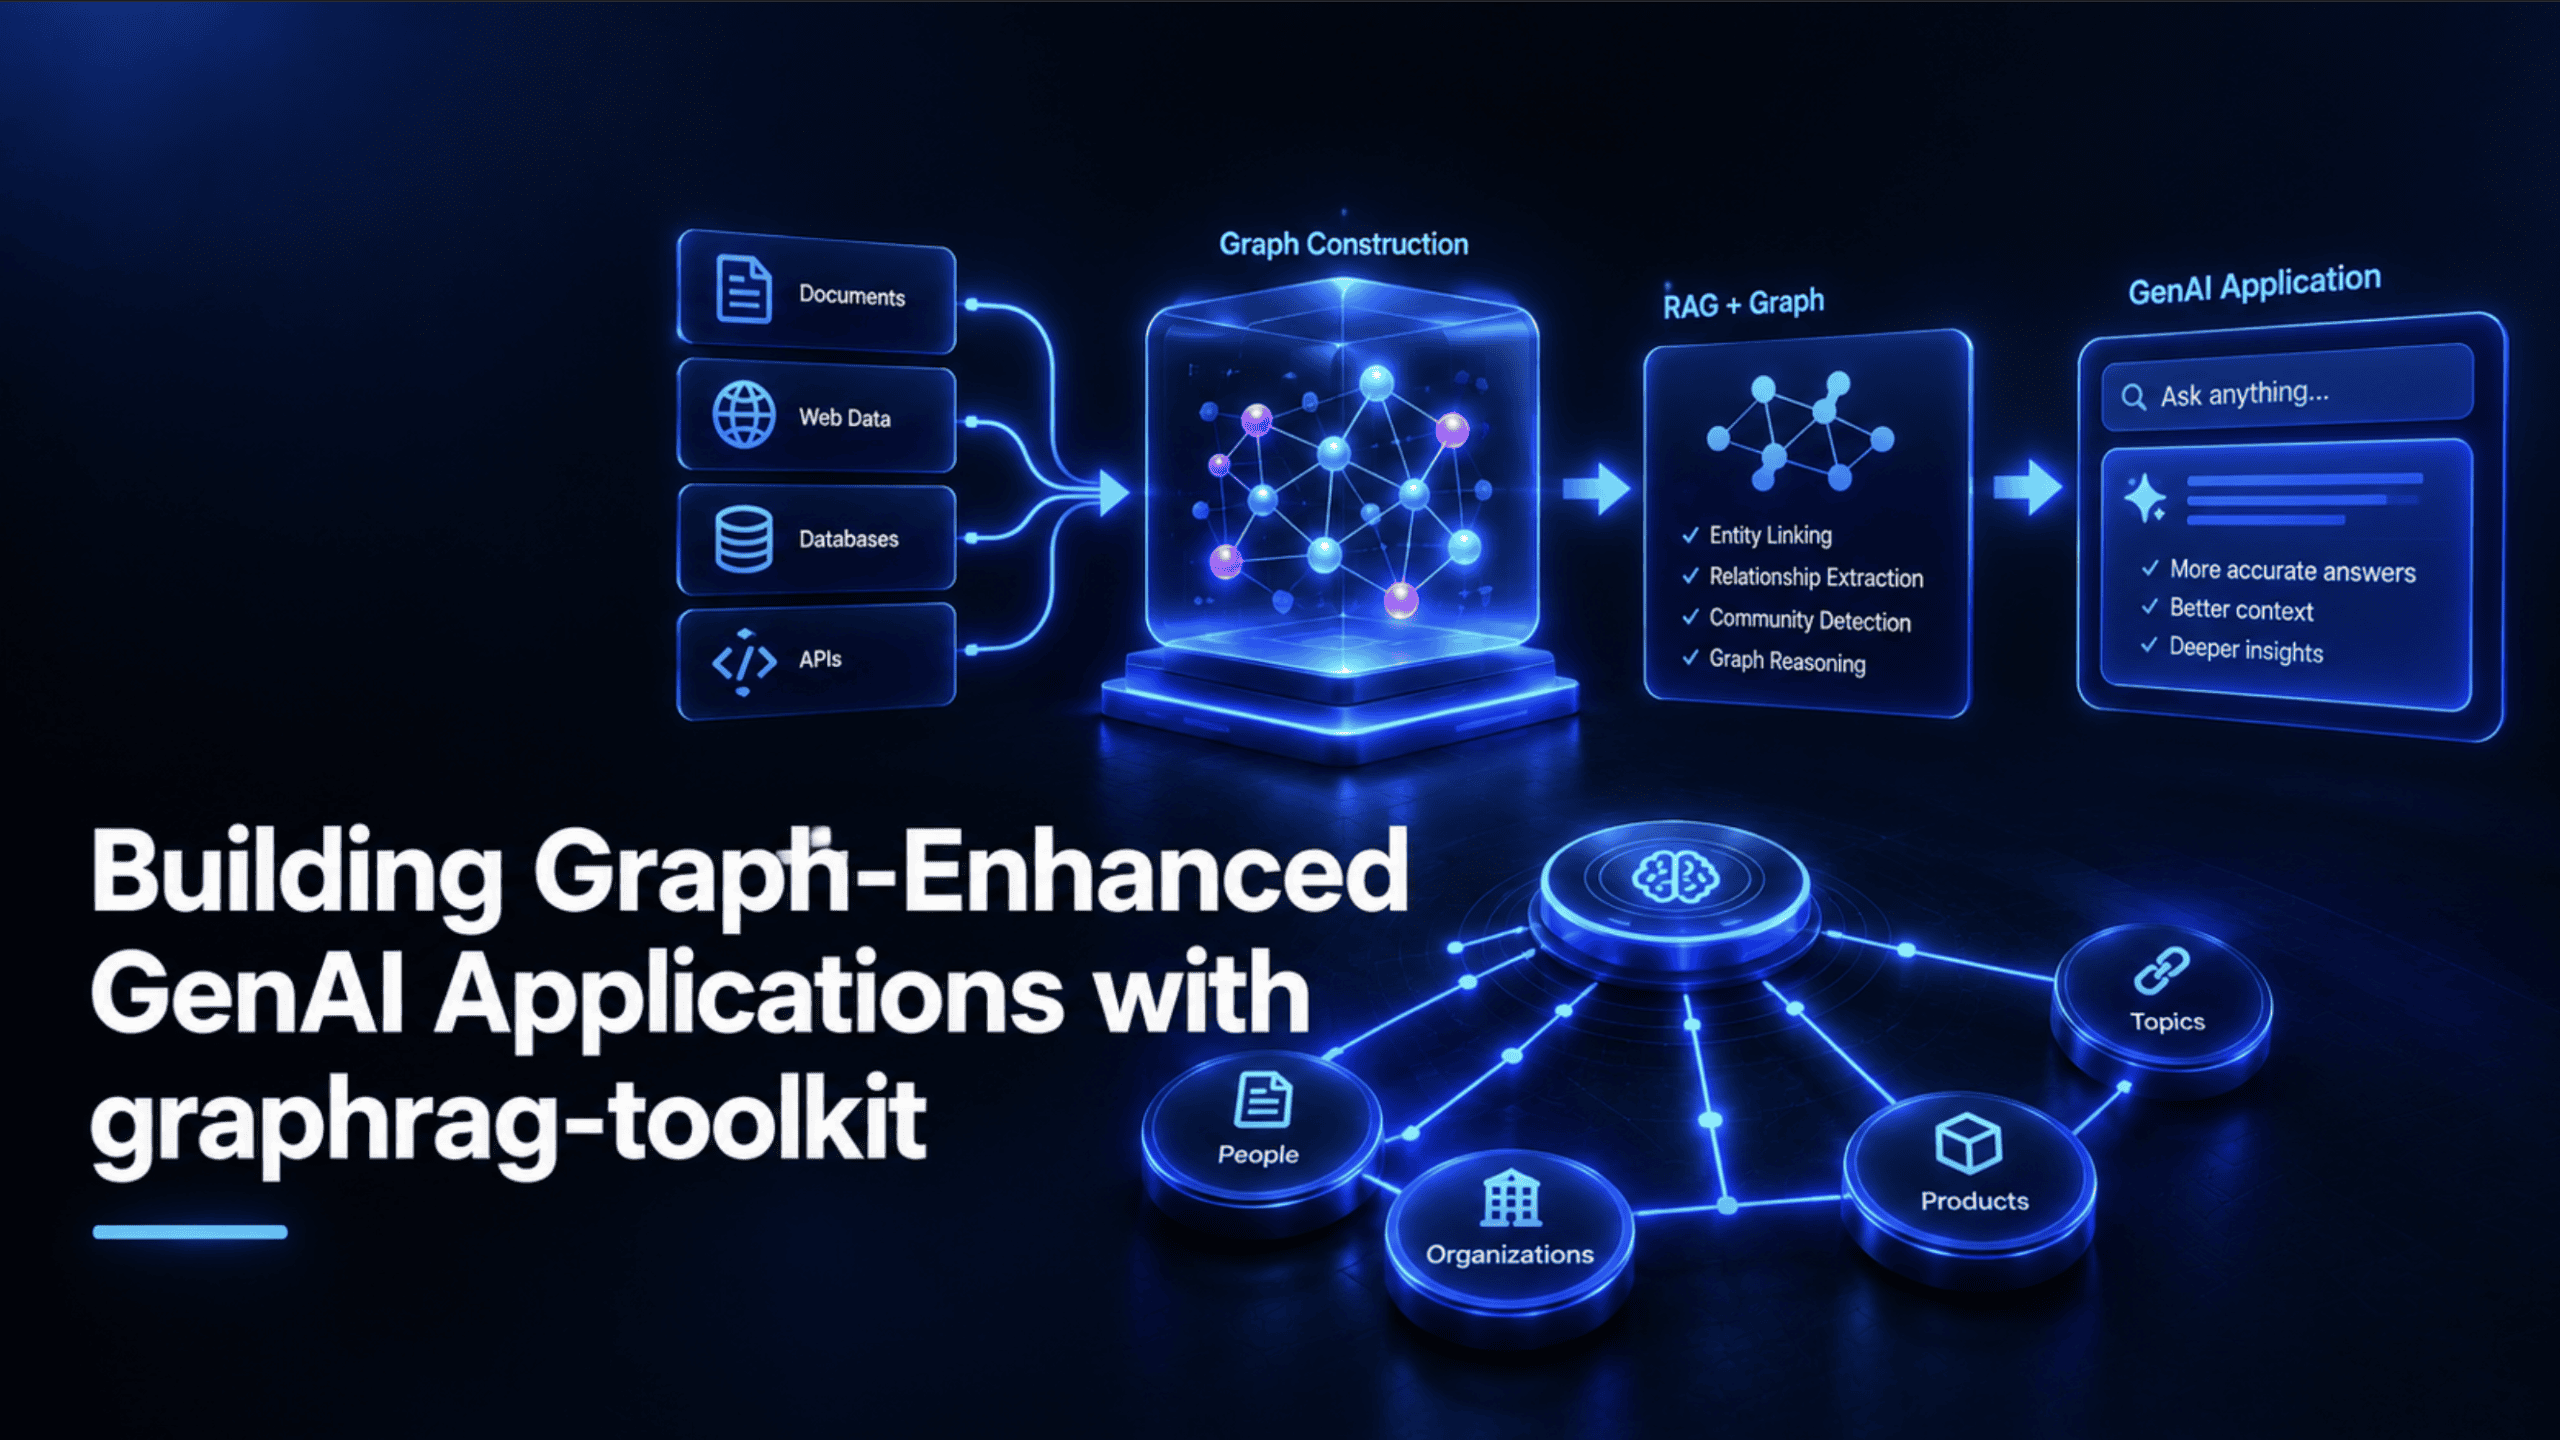
Mit LLM Wiki hat der Entwickler nashsu eine neuartige plattformübergreifende Desktop-Anwendung vorgestellt, die auf GitHub Trending Aufmerksamkeit erregt. Das Tool wandelt eigene Dokumente vollautomatisch in eine strukturierte, untereinander verknüpfte Wissensdatenbank um. Im Gegensatz zu traditionellen Retrieval-Augmented-Generation-Ansätzen (RAG), bei denen für jede einzelne Anfrage Dokumente neu durchsucht und Antworten von Grund auf generiert werden müssen, verfolgt LLM Wiki ein anderes Konzept: Ein großes Sprachmodell baut schrittweise auf Basis der bereitgestellten Quelldateien ein dauerhaftes Wiki auf und pflegt dieses kontinuierlich. Dieser Ansatz verbindet die Vorzüge von Wissensgraphen und klassischen Wikis mit den Fähigkeiten moderner Sprachmodelle direkt auf dem Desktop des Nutzers.
Die wichtigsten Punkte
- Plattformübergreifende Desktop-Anwendung: LLM Wiki von Entwickler nashsu läuft als Desktop-Applikation über mehrere Betriebssysteme hinweg und richtet sich an die lokale Dokumentenverwaltung.
- Automatisierte Strukturierung: Das Tool transformiert statische Dokumente eigenständig in eine geordnete und in sich vernetzte Wissensbasis.
- Unterschied zu RAG: Anders als bei herkömmlichen RAG-Systemen, die bei jeder Anfrage von vorn suchen und antworten, wird ein dauerhaftes, zusammenhängendes Wiki gepflegt.
- Schrittweiser Aufbau: Ein großes Sprachmodell erstellt das Wiki inkrementell anhand der vorgelegten Quelldateien und hält die Inhalte langfristig auf dem neuesten Stand.
Analyse
Funktionsweise von LLM Wiki als Desktop-Lösung
LLM Wiki präsentiert sich als Desktop-Anwendung, die plattformübergreifend verfügbar ist und darauf abzielt, die Organisation von Dokumenten grundlegend zu verändern. Nutzerinnen und Nutzer stehen häufig vor dem Problem, dass sich in Organisationen oder im persönlichen Arbeitsalltag unzählige Dokumente, Textdateien und Notizen ansammeln. Diese Quelldokumente liegen oft unverbunden nebeneinander, was das Auffinden von Zusammenhängen erschwert.
Die Anwendung greift hier ein, indem sie die vorhandenen Ausgangsdateien als Grundlage nimmt und diese automatisiert verarbeitet. Das integrierte große Sprachmodell analysiert die Quelldateien und überführt sie in eine strukturierte, miteinander verlinkte Wiki-Struktur. Durch die Verknüpfung der einzelnen Themen und Inhalte entsteht eine zusammenhängende Wissensdatenbank, die weit über eine bloße Ablage einzelner Textdateien hinausgeht. Indem die Anwendung als Desktop-Software konzipiert ist, wird die Verwaltung der eigenen Dokumentensammlung direkt in die Arbeitsumgebung der Anwender eingebunden.
Der fundamentale Unterschied zu herkömmlichen RAG-Architekturen
Ein zentraler Aspekt von LLM Wiki ist die bewusste Abgrenzung von herkömmlichen Retrieval-Augmented-Generation-Verfahren (RAG). Bei klassischen RAG-Verfahren läuft die Interaktion in der Regel so ab, dass ein Nutzer eine konkrete Suchanfrage stellt. Das System durchsucht daraufhin eine Datenbank oder einen Vektorindex, extrahiert die mutmaßlich relevanten Textabschnitte und übergibt diese zusammen mit der Benutzeranfrage an das Sprachmodell. Dieser Vorgang beginnt bei jeder neuen Eingabe wieder von vorn, ohne dass ein strukturiertes Gesamtwissen dauerhaft festgehalten wird.
LLM Wiki wählt hier einen grundlegend anderen Weg. Anstatt bei jeder Frage punktuell und isoliert nach Inhalten zu suchen, konstruiert das Sprachmodell ein persistentes Wiki. Das bedeutet, dass das Modell aus den Quelldateien schrittweise ein festes Wissensnetzwerk aufbaut. Jedes Dokument wird in den Gesamtkontext eingeordnet, Querverbindungen werden generiert und die Wissensbasis wird dauerhaft gesichert. Wenn neue Dokumente hinzukommen oder bestehende angepasst werden, pflegt das Sprachmodell das Wiki sukzessive weiter. Das Wissen liegt somit bereits vorformuliert, verknüpft und übersichtlich gegliedert vor, statt erst im Moment der Abfrage ad hoc zusammengestellt werden zu müssen.
Schrittweise Pflege und Beständigkeit des Wissens
Die Fähigkeit, eine Wissensbasis inkrementell aufzubauen und zu erhalten, löst eine zentrale Herausforderung beim Umgang mit umfangreichen Datenmengen. Anstatt den gesamten Korpus bei jeder Aktualisierung vollständig neu analysieren zu müssen, vollzieht sich der Prozess schrittweise anhand der vorliegenden Quelldateien. Das große Sprachmodell übernimmt dabei die Rolle eines kontinuierlichen Redakteurs, der die Beziehungen zwischen verschiedenen Dokumenten erkennt und diese durch Querverweise transparent macht.
Durch diese permanente Pflege bleibt die Wissensdatenbank zu jedem Zeitpunkt konsistent und geordnet. Das Resultat ist ein langlebiges Informationssystem, in dem Dokumente nicht mehr isoliert nebeneinanderstehen, sondern als integrierte Wissensbestandteile eines kohärenten Wikis fungieren.
Bedeutung für die KI-Branche
Das Projekt LLM Wiki verdeutlicht eine wichtige Weiterentwicklung in der Nutzung großer Sprachmodelle für das Wissensmanagement. Während sich ein Großteil der aktuellen Entwicklungen auf standardisierte RAG-Pipelines konzentriert, zeigt LLM Wiki das Potenzial auf, Sprachmodelle nicht nur als situative Such- und Antwortwerkzeuge einzusetzen, sondern als aktive Konstrukteure strukturierter, langlebiger Informationsarchitekturen.
Die Bereitstellung als Desktop-Anwendung unterstreicht zudem den Trend, fortschrittliche Dokumentenverarbeitung direkt für Endanwender zugänglich zu machen. Die schrittweise Erstellung eines miteinander verlinkten Wikis demonstriert, wie Wissensgraphen und textbasierte Wissensdatenbanken automatisiert entstehen können, ohne dass menschliche Redakteurinnen und Redakteure jeden Querverweis händisch pflegen müssen. Für Entwickler und Anwender bietet dieser Ansatz ein alternatives Paradigma zur bloßen Vektorsuche, indem er den Schwerpunkt auf Beständigkeit, klare Gliederung und zusammenhängende Navigation legt.
Häufig gestellte Fragen
Was ist der Hauptunterschied zwischen LLM Wiki und traditionellem RAG?
Traditionelle RAG-Systeme führen bei jeder neuen Frage eine isolierte Suche in den Daten durch und generieren daraus ad hoc eine Antwort. LLM Wiki hingegen baut aus den Quelldateien mithilfe eines großen Sprachmodells schrittweise ein persistentes, fest verlinktes und klar strukturiertes Wiki auf, das dauerhaft gepflegt wird.
Auf welchen Betriebssystemen kann LLM Wiki genutzt werden?
Laut den Entwicklerangaben handelt es sich bei LLM Wiki um eine plattformübergreifende Desktop-Anwendung, die für den Einsatz auf verschiedenen gängigen Desktop-Betriebssystemen ausgelegt ist.
Wie werden neue oder bestehende Dokumente in LLM Wiki verarbeitet?
Das große Sprachmodell analysiert die Quelldateien schrittweise, ordnet die Inhalte thematisch ein und erzeugt automatisch Verknüpfungen zwischen den Themen, wodurch ein stetig wachsendes und gepflegtes Gesamtwiki entsteht.