Der lokale KI-Stack für produktive SLMs: Ein praktisches Framework für die Werkzeugauswahl
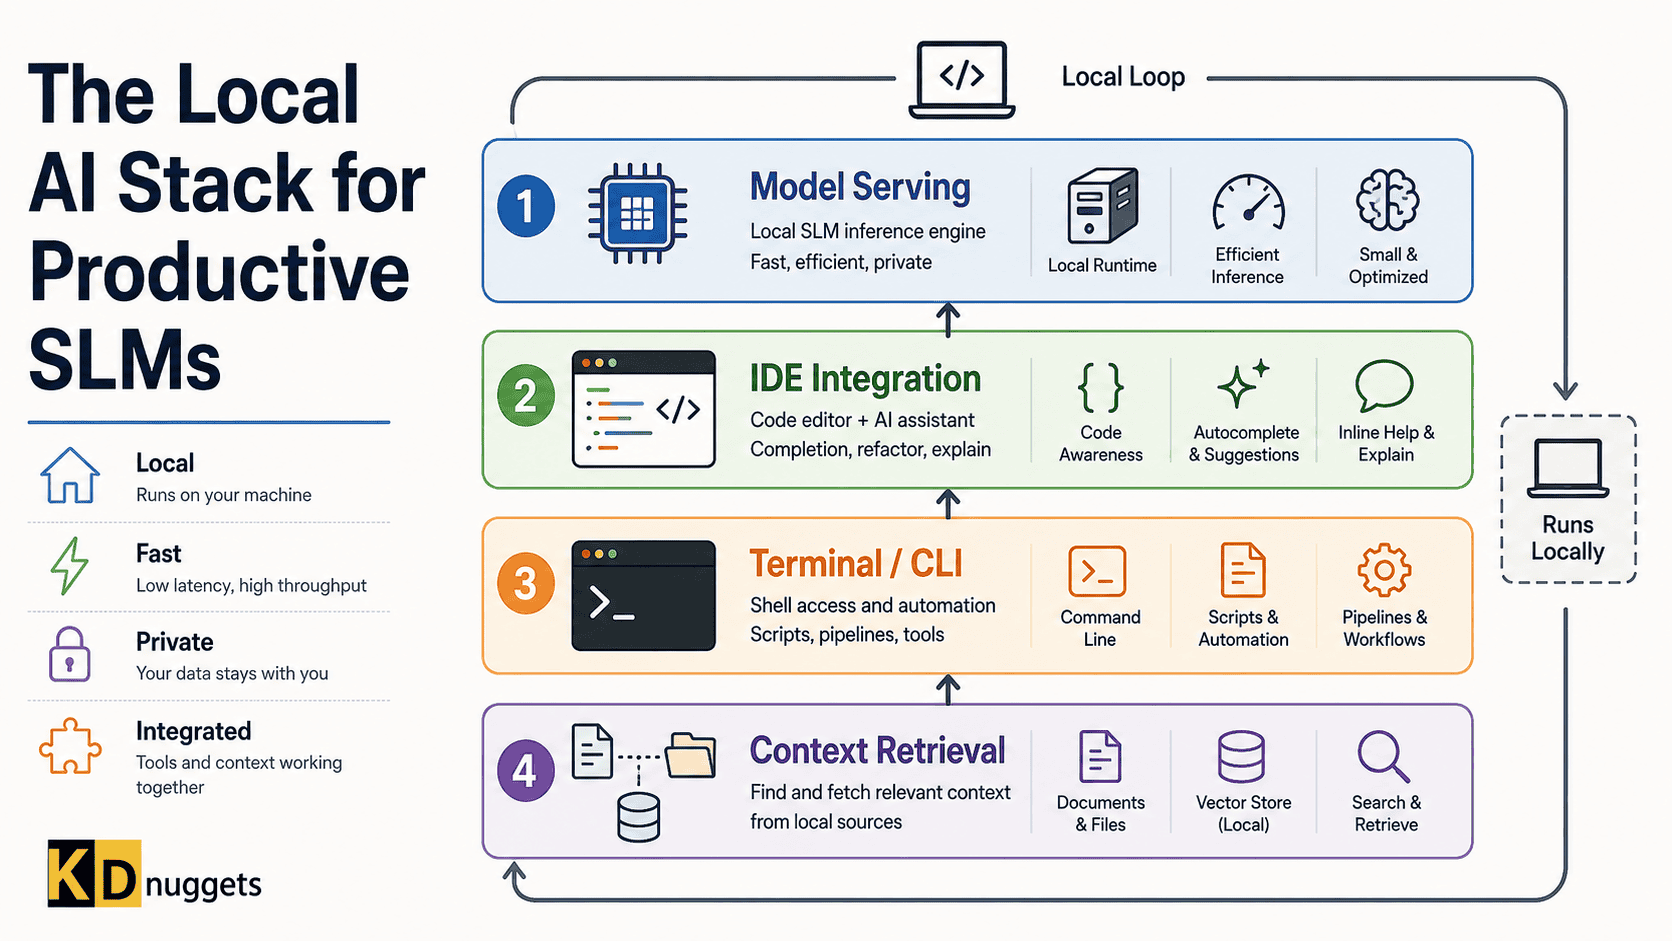
In der Originalmeldung von KDnuggets stellt der Autor Vinod Chugani ein praktisches Framework für den Aufbau eines lokalen KI-Stacks vor. Der Fokus liegt dabei auf der produktiven Nutzung von Small Language Models (SLMs). Der Artikel adressiert die Herausforderung, die passenden Werkzeuge für jede Ebene der lokalen Infrastruktur auszuwählen. Dies umfasst den gesamten Prozess von der Modellbereitstellung (Model Serving) bis hin zur Kontextabfrage (Context Retrieval). Ziel des Frameworks ist es, Entwicklern und Unternehmen eine strukturierte Entscheidungsgrundlage zu bieten, um effiziente und leistungsstarke KI-Anwendungen lokal zu betreiben, ohne auf Cloud-Ressourcen angewiesen zu sein. Die Analyse verdeutlicht die wachsende Bedeutung von SLMs und die Notwendigkeit einer sorgfältig abgestimmten Tool-Landschaft für lokale Umgebungen.
Die wichtigsten Punkte
- Strukturiertes Framework: Vorstellung eines praktischen Leitfadens zur Auswahl der richtigen Tools für lokale KI-Infrastrukturen.
- Fokus auf SLMs: Optimierung des Stacks speziell für Small Language Models (SLMs), um Produktivität und Effizienz zu steigern.
- Ganzheitlicher Ansatz: Abdeckung aller relevanten Ebenen, beginnend beim Model Serving bis hin zum Context Retrieval.
- Lokale Unabhängigkeit: Unterstützung beim Aufbau einer produktiven KI-Umgebung, die vollständig lokal betrieben werden kann.
Analyse
Das Framework für den lokalen KI-Stack
Die Originalmeldung beschreibt die Notwendigkeit eines strukturierten Frameworks, um die Komplexität lokaler KI-Installationen zu bewältigen. Ein zentraler Aspekt ist dabei die Auswahl der Werkzeuge auf jeder Ebene des Stacks. Da die Landschaft der KI-Tools schnell wächst, bietet das vorgestellte Framework eine Orientierungshilfe, um sicherzustellen, dass die gewählten Komponenten nahtlos ineinandergreifen. Dies ist besonders wichtig für die Produktivität, da inkompatible oder ineffiziente Tools den Workflow bei der Arbeit mit Small Language Models (SLMs) erheblich behindern können.
Der Fokus auf lokale Setups unterstreicht einen Trend in der Branche, bei dem Datenschutz, Latenz und Kostenkontrolle im Vordergrund stehen. Durch den Einsatz eines lokalen Stacks behalten Entwickler die volle Kontrolle über ihre Daten und die Ausführung der Modelle.
Von der Modellbereitstellung bis zum Context Retrieval
Ein wesentlicher Teil des Frameworks widmet sich den verschiedenen Schichten der KI-Infrastruktur. Hierbei werden zwei Kernbereiche besonders hervorgehoben:
- Model Serving: Dies ist die unterste Ebene, die definiert, wie das Modell geladen, verwaltet und für Anfragen zugänglich gemacht wird. Die Wahl des richtigen Serving-Tools ist entscheidend für die Performance der SLMs auf lokaler Hardware.
- Context Retrieval: Damit KI-Modelle präzise und kontextbezogene Antworten liefern können, ist eine effiziente Methode zur Informationsbeschaffung notwendig. Das Framework unterstützt dabei, Tools zu identifizieren, die relevanten Kontext aus lokalen Datenquellen extrahieren und dem Modell zur Verfügung stellen.
Durch die Verknüpfung dieser Ebenen entsteht ein kohärentes System, das über die reine Modellausführung hinausgeht und echte produktive Anwendungen ermöglicht.
Bedeutung für die KI-Branche
Die Veröffentlichung dieses Frameworks signalisiert eine Verschiebung in der KI-Entwicklung weg von reinen Cloud-Lösungen hin zu hybriden oder vollständig lokalen Architekturen. Small Language Models (SLMs) spielen hierbei eine Schlüsselrolle, da sie weniger Rechenleistung benötigen und somit ideal für den lokalen Betrieb geeignet sind. Ein standardisiertes Framework für die Tool-Auswahl senkt die Eintrittsbarrieren für Unternehmen, die eigene KI-Kapazitäten aufbauen möchten, ohne sensible Daten an externe Provider zu übermitteln. Dies fördert die Innovation auf lokaler Ebene und ermöglicht spezialisierte, hochperformante Anwendungen in geschützten Umgebungen.
Häufig gestellte Fragen
Was ist ein lokaler KI-Stack?
Ein lokaler KI-Stack ist eine Kombination aus Software-Werkzeugen und Hardware-Ressourcen, die es ermöglicht, KI-Modelle wie SLMs auf eigener Infrastruktur zu betreiben, anstatt Cloud-Dienste zu nutzen. Er umfasst Ebenen wie das Betriebssystem, Treiber, Model-Serving-Frameworks und Datenabrufsysteme.
Warum sind SLMs für lokale Stacks besonders geeignet?
Small Language Models (SLMs) haben im Vergleich zu Large Language Models (LLMs) eine geringere Anzahl an Parametern. Dadurch benötigen sie weniger Speicher und Rechenkraft (GPU/CPU), was sie ideal für die Ausführung auf lokaler Hardware bei gleichzeitig hoher Produktivität macht.
Welche Rolle spielt das Context Retrieval in diesem Framework?
Context Retrieval ist der Prozess, bei dem relevante Informationen aus einer Datenbasis abgerufen werden, um die Eingabe für das KI-Modell anzureichern. Im lokalen Stack stellt es sicher, dass das SLM Zugriff auf spezifisches Wissen hat, ohne dass das gesamte Modell neu trainiert werden muss.