
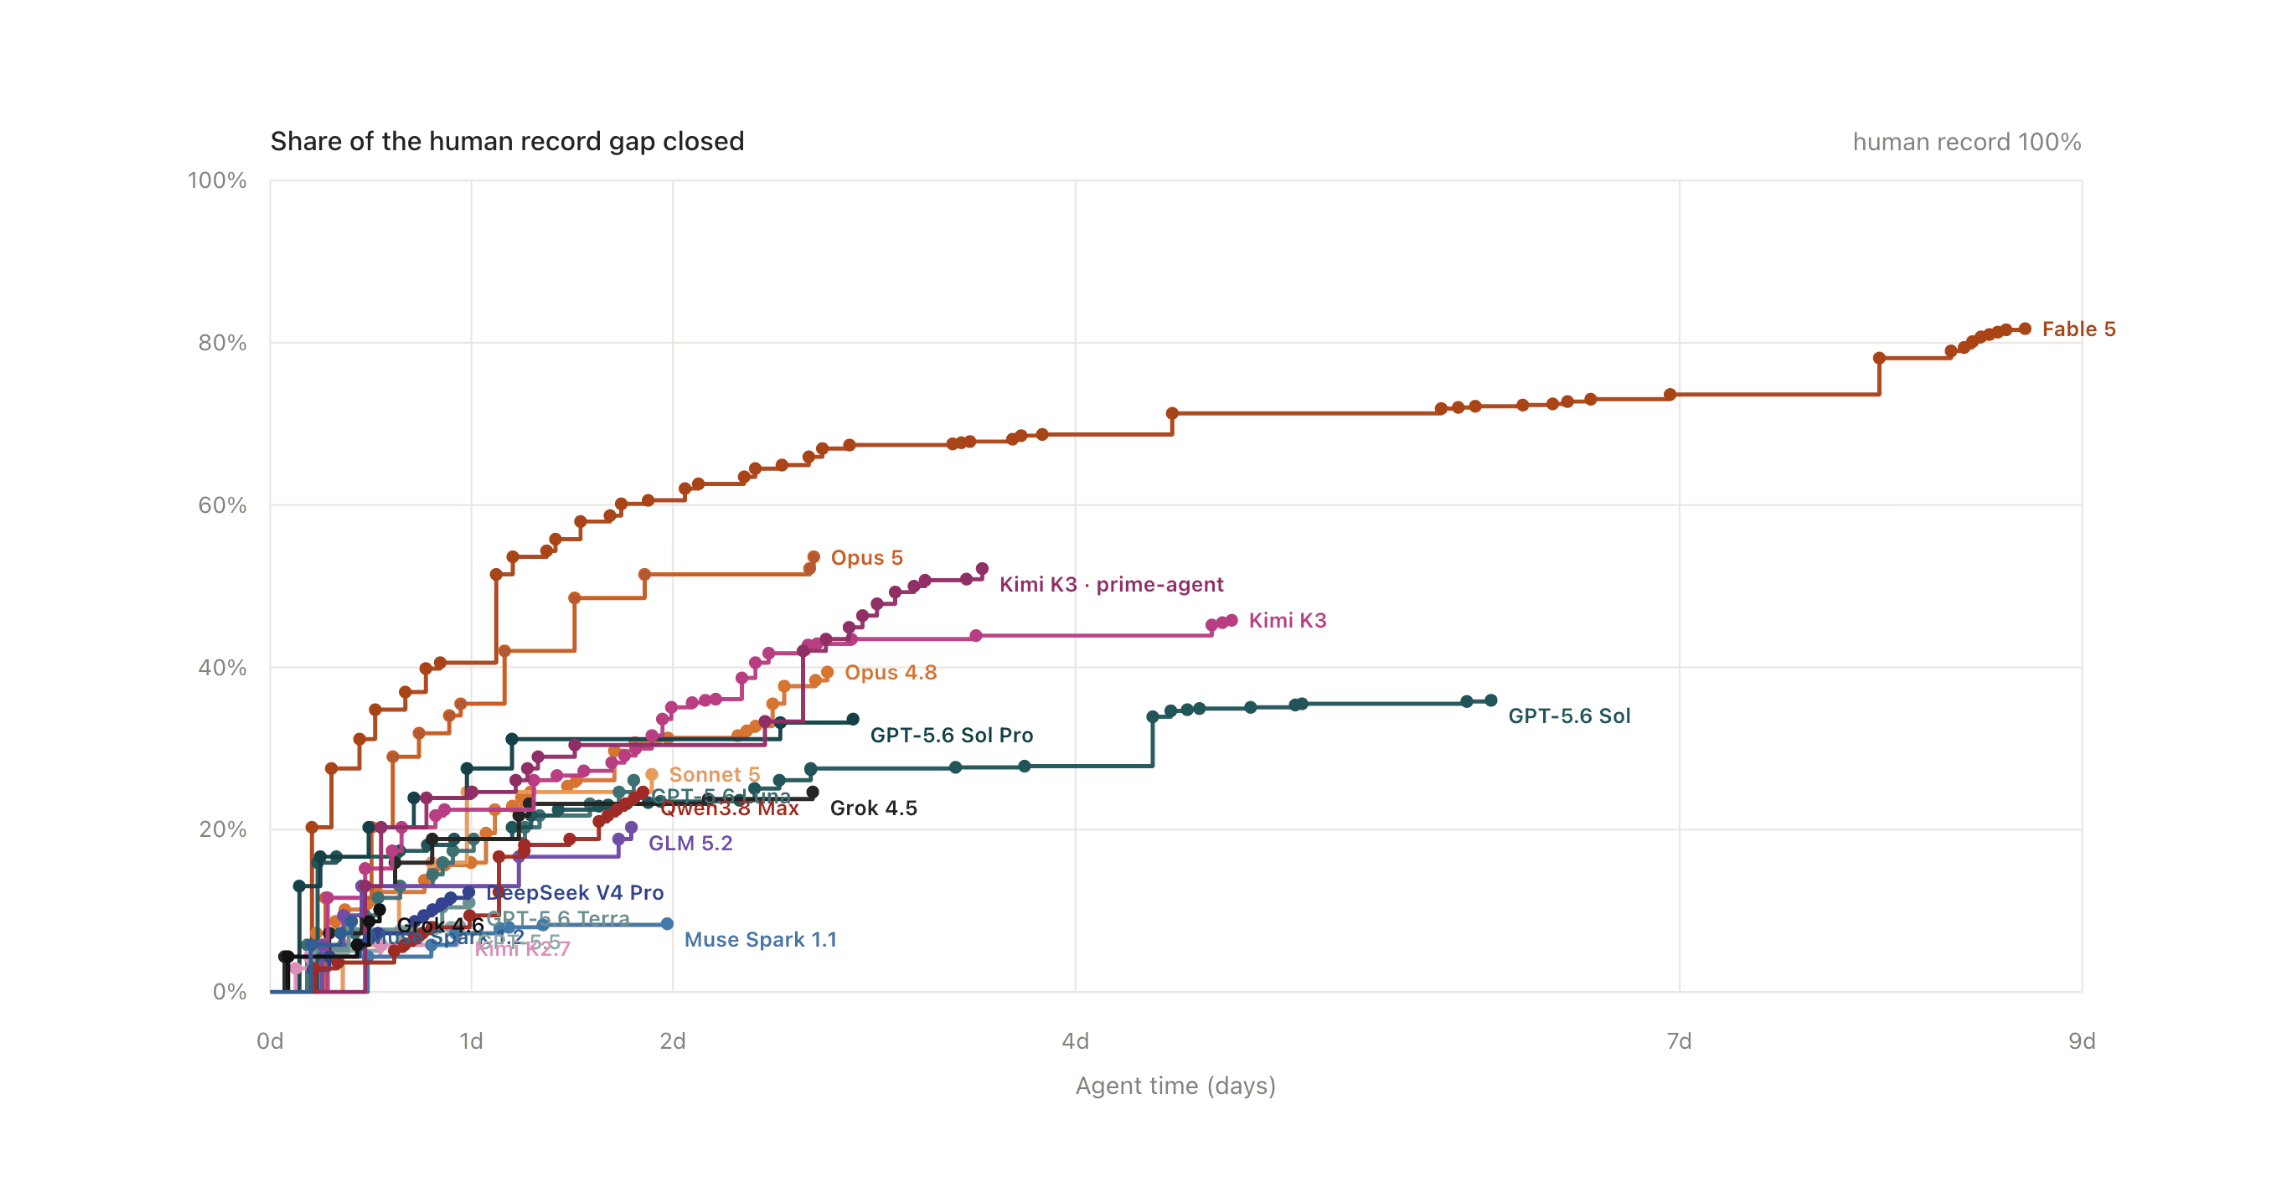
NanoGPT Speedrun Frontier: Fable 5 führt das Feld beim Schließen der Lücke zum menschlichen Rekord mit über 80 Prozent an
Die aktuelle Auswertung des NanoGPT Speedrun Frontier, veröffentlicht von Prime Intellect am 22. August 2026, zeigt signifikante Fortschritte von KI-Modellen beim Erreichen menschlicher Leistungsniveaus. Fable 5 setzt sich mit einem geschlossenen Anteil von 81,7 % an die Spitze der Rangliste, gefolgt von Opus 5 und Kimi K3, die beide die 50-Prozent-Marke überschreiten konnten. Die Daten verdeutlichen den Einsatz spezialisierter Agenten-Frameworks wie claude-code, prime-agent und codex, um komplexe Optimierungsaufgaben zu bewältigen. Während Spitzenreiter wie Fable 5 über acht Tage für ihre Ergebnisse benötigten, zeigen Modelle wie Sonnet 5 und GPT-5.6 Luna eine hohe Effizienz in deutlich kürzeren Zeiträumen von unter zwei Tagen. Die Analyse bietet einen detaillierten Einblick in die aktuelle Wettbewerbslandschaft der KI-Entwicklung und die Effektivität verschiedener Modellarchitekturen.
Die wichtigsten Punkte
- Fable 5 dominiert das Ranking: Mit 81,7 % hat Fable 5 den bisher größten Anteil der Lücke zum menschlichen Rekord geschlossen.
- Spitzenfeld über 50 %: Neben Fable 5 konnten auch Opus 5 (53,6 %) und Kimi K3 (52,2 %) mehr als die Hälfte der Differenz zum menschlichen Benchmark überwinden.
- Vielfalt der Agenten-Frameworks: Der Einsatz von spezialisierten Tools wie claude-code, prime-agent, codex und grok-cli ist entscheidend für die erzielten Ergebnisse.
- Zeitfaktor und Effizienz: Die benötigte Zeit der Agenten variiert stark, von 0,6 Tagen bei Grok 4.6 bis zu 8,7 Tagen bei Fable 5.
- Breites Spektrum an Modellen: Die Liste umfasst führende Modelle wie GPT-5.6 (in den Varianten Sol, Luna und Terra), Grok 4.5/4.6, Qwen3.8 Max und DeepSeek V4 Pro.
Analyse
Die Spitzenreiter im NanoGPT Speedrun
Die Daten von Prime Intellect zeigen eine klare Hierarchie in der aktuellen Leistungsfähigkeit von KI-Modellen im Kontext des NanoGPT Speedruns. Fable 5 nimmt eine Ausnahmestellung ein. Mit einem validierten Ergebnis von 2.726 schloss das Modell 81,7 % der Lücke zum menschlichen Rekord. Dieser Erfolg wurde unter Verwendung des claude-code Frameworks in der Konfiguration „high @24H“ über einen Zeitraum von 8,7 Tagen erzielt.
Auf den Plätzen zwei und drei folgen Opus 5 und Kimi K3. Opus 5 erreichte in der „serial era“ ein Ergebnis von 2.920 und schloss damit 53,6 % der Lücke. Hierbei kam ebenfalls claude-code (Konfiguration „max @24H“) zum Einsatz, wobei die benötigte Zeit mit 2,9 Tagen deutlich geringer ausfiel als beim Erstplatzierten. Kimi K3 erzielte mit dem prime-agent ein Ergebnis von 2.930 (52,2 % der Lücke) in 3,6 Tagen. Ein zweiter Eintrag für Kimi K3 unter Verwendung von kimi-code zeigt ein Ergebnis von 2.974 und 45,8 % geschlossene Lücke nach 5,1 Tagen.
Effizienz und Agenten-Performance
Ein wesentlicher Aspekt der Analyse ist das Verhältnis zwischen der investierten Zeit („Agent time“) und dem erzielten Fortschritt. Während Fable 5 für seinen Spitzenwert fast 9 Tage benötigte, zeigen andere Modelle bemerkenswerte Ergebnisse in kürzerer Zeit:
- Sonnet 5: Erreichte 26,8 % der Lücke (Ergebnis 3.105) in nur 2,0 Tagen.
- GPT-5.6 Luna: Erzielte 26,1 % (Ergebnis 3.110) in 1,9 Tagen unter Verwendung von codex.
- GLM 5.2: Schloss 20,3 % der Lücke in 1,8 Tagen.
Die GPT-5.6-Familie ist mit mehreren Varianten vertreten. GPT-5.6 Sol erreichte 35,9 % der Lücke in 6,1 Tagen, während die Pro-Version von Sol 33,6 % in nur 3,4 Tagen schaffte. Die Variante GPT-5.6 Terra benötigte lediglich 1,1 Tage für einen Fortschritt von 11,0 %.
Interessant ist auch der Status laufender Modelle. Qwen3.8 Max und DeepSeek V4 Pro befinden sich zum Zeitpunkt der Datenerhebung noch im Prozess („running“). Qwen3.8 Max liegt aktuell bei 24,6 % (1,9 Tage), während DeepSeek V4 Pro 12,3 % nach 1,1 Tagen verzeichnet.
Technischer Kontext der Ergebnisse
Die Rangliste differenziert zwischen verschiedenen Validierungsstufen und Trajektorien. Die Ergebnisse basieren auf dem „Best validated result for each model“. Dabei werden verschiedene Konfigurationen der Agenten genutzt, wie beispielsweise „max @24H“, „high @24H“ oder „xhigh @24H“. Diese Suffixe deuten auf unterschiedliche Intensitätsstufen oder Rechenzeitbegrenzungen pro 24-Stunden-Intervall hin.
Modelle wie Grok 4.5 (24,6 % in 2,7 Tagen) und Grok 4.6 (10,1 % in 0,6 Tagen) nutzen das grok-cli in der „xhigh“-Konfiguration. Die Daten zeigen, dass neuere Iterationen oder spezifische Konfigurationen oft darauf abzielen, die Zeit bis zum Ergebnis zu verkürzen, auch wenn der absolute Prozentsatz der geschlossenen Lücke noch nicht an die Spitzenwerte von Fable 5 heranreicht.
Bedeutung für die KI-Branche
Der NanoGPT Speedrun Frontier dient als wichtiger Benchmark für die Fähigkeit von KI-Agenten, komplexe Programmier- und Optimierungsaufgaben autonom zu lösen. Die Ergebnisse verdeutlichen, dass die Branche sich in einer Phase befindet, in der nicht mehr nur die reine Modellkapazität zählt, sondern die Kombination aus Modell und spezialisiertem Agenten-Framework (wie claude-code oder prime-agent).
Die Tatsache, dass Fable 5 bereits über 80 % der Lücke zum menschlichen Rekord schließen konnte, deutet darauf hin, dass die Grenze zur menschlichen Leistungsfähigkeit in spezialisierten Coding-Aufgaben zunehmend verschwimmt. Zudem zeigt die Präsenz zahlreicher internationaler Akteure – von Anthropic (Opus/Sonnet) über OpenAI (GPT-Varianten) bis hin zu Alibaba (Qwen) und DeepSeek – den intensiven globalen Wettbewerb in diesem Bereich.
Häufig gestellte Fragen
Welches Modell führt den NanoGPT Speedrun aktuell an?
Fable 5 ist der aktuelle Spitzenreiter. Es hat 81,7 % der Lücke zum menschlichen Rekord geschlossen und erreichte ein validiertes Ergebnis von 2.726.
Welche Rolle spielen die Agenten wie claude-code oder codex?
Diese Agenten fungieren als Frameworks, die die Modelle steuern, um die Aufgaben des Speedruns auszuführen. Die Wahl des Agenten und dessen Konfiguration (z. B. „max @24H“) hat einen signifikanten Einfluss auf das Endergebnis und die benötigte Zeit.
Wie lange benötigen die KI-Modelle für einen Durchlauf?
Die Zeitspanne ist sehr unterschiedlich. Während einige Modelle wie Grok 4.6 weniger als einen Tag (0,6 Tage) benötigen, investierte der Spitzenreiter Fable 5 insgesamt 8,7 Tage, um sein Ergebnis zu erzielen.

