
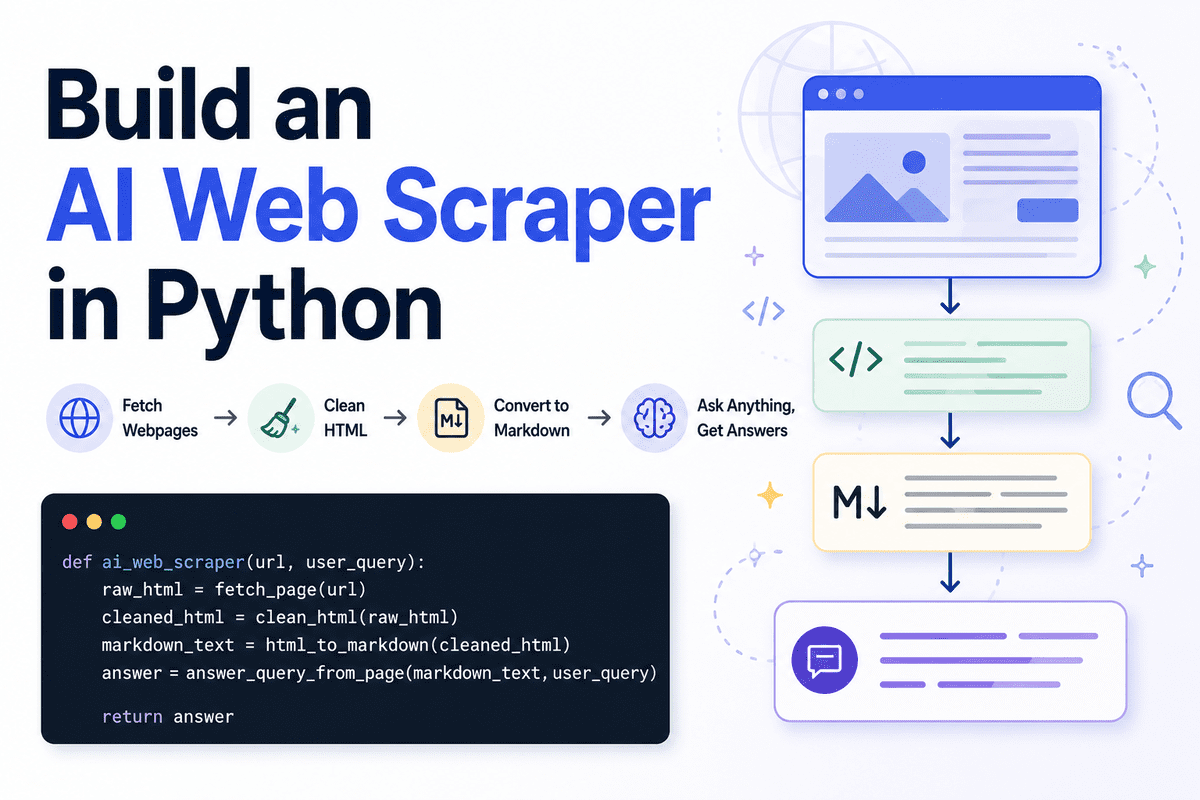
Wie man einen einfachen KI-Web-Scraper mit Python baut: Effiziente Datenextraktion für LLMs
Dieser Artikel erläutert die Entwicklung eines leichtgewichtigen, KI-gestützten Web-Scrapers auf Basis von Python. Die Methode transformiert herkömmliche Webseiten in eine spezialisierte QA-Engine (Question-Answering), indem sie rohes HTML bereinigt und in das Markdown-Format konvertiert. Ein zentraler Aspekt dieses Prozesses ist die Optimierung der Daten für Large Language Models (LLMs). Durch die gezielte Reduzierung von unnötigem Code-Ballast wird nicht nur die Präzision der Antworten verbessert, sondern auch der Token-Verbrauch signifikant gesenkt. Dies macht den Scraper zu einem effizienten Werkzeug für Entwickler, die Webinhalte kostengünstig und präzise durch KI-Modelle analysieren lassen möchten. Der Fokus liegt dabei auf einer sauberen Datenstruktur als Grundlage für hochwertige KI-Interaktionen.
Die wichtigsten Punkte
- Transformation von Webinhalten: Webseiten werden in eine leichtgewichtige, LLM-gestützte QA-Engine umgewandelt.
- Effiziente Datenbereinigung: Durch das Entfernen von unnötigem HTML-Code wird die Datenqualität für die KI erhöht.
- Markdown-Konvertierung: Die Umwandlung in Markdown dient als Brücke für eine bessere Lesbarkeit durch Sprachmodelle.
- Token-Optimierung: Die Reduzierung des Datenvolumens führt zu einem geringeren Token-Verbrauch und damit zu niedrigeren Kosten.
- Fokussierte Antworten: Das System liefert präzise Antworten, indem es sich auf den wesentlichen Inhalt der Webseite konzentriert.
Analyse
Vom rohen HTML zur strukturierten QA-Engine
Der Prozess beginnt mit der Erfassung von Webseiteninhalten, die in ihrer Rohform oft durch komplexe HTML-Strukturen, Skripte und Metadaten überladen sind. Für ein Large Language Model (LLM) stellt dieser „Lärm“ eine Herausforderung dar, da er die relevanten Informationen verdeckt. Der vorgestellte Ansatz nutzt Python, um diese HTML-Strukturen systematisch zu bereinigen. Das Ziel ist es, eine Umgebung zu schaffen, in der eine Webseite nicht mehr nur ein statisches Dokument ist, sondern als dynamische Wissensquelle für eine QA-Engine fungiert. Durch die Bereinigung wird sichergestellt, dass die KI nur die Informationen verarbeitet, die tatsächlich zur Beantwortung von Nutzeranfragen beitragen.
Die Rolle von Markdown bei der Token-Reduzierung
Ein entscheidender technischer Schritt in diesem Workflow ist die Konvertierung der bereinigten Inhalte in das Markdown-Format. Markdown bietet gegenüber HTML den Vorteil, dass es eine klare Struktur (wie Überschriften und Listen) beibehält, dabei aber auf die umfangreiche Syntax von HTML-Tags verzichtet. In der Welt der generativen KI ist dies von strategischer Bedeutung: LLMs verarbeiten Informationen in Form von Token. Da HTML-Tags viele Token verbrauchen können, ohne inhaltlichen Mehrwert zu bieten, führt die Konvertierung in Markdown zu einer erheblichen Effizienzsteigerung. Weniger Token bedeuten nicht nur eine schnellere Verarbeitung, sondern reduzieren auch direkt die API-Kosten, die bei der Nutzung kommerzieller Sprachmodelle anfallen.
Optimierung der Antwortqualität
Indem der Fokus auf den bereinigten und konvertierten Text gelegt wird, ist das LLM in der Lage, fokussiertere Antworten zu generieren. Die QA-Engine muss sich nicht durch irrelevanten Code arbeiten, was die Wahrscheinlichkeit von Fehlinterpretationen verringert. Dieser Prozess der Vorverarbeitung stellt sicher, dass die KI-Modelle ihre Kapazitäten voll auf die inhaltliche Analyse und die präzise Beantwortung der gestellten Fragen konzentrieren können. Es handelt sich somit um eine Methode, die sowohl die technische Effizienz als auch die inhaltliche Genauigkeit von KI-Anwendungen steigert.
Bedeutung für die KI-Branche
Die Fähigkeit, Webinhalte effizient für KI-Modelle aufzubereiten, ist ein kritischer Faktor für die Skalierung von KI-Anwendungen. In einer Branche, in der die Kosten für Token und die Begrenzung von Kontextfenstern zentrale Herausforderungen darstellen, bietet dieser Ansatz eine praktische Lösung. Die Kombination aus klassischem Web-Scraping und moderner KI-Verarbeitung zeigt auf, wie spezialisierte Werkzeuge gebaut werden können, die kosteneffizient arbeiten, ohne an Leistung einzubüßen. Dies ebnet den Weg für intelligentere Datenextraktions-Tools, die nahtlos in größere KI-Ökosysteme integriert werden können.
Häufig gestellte Fragen
Warum ist die HTML-Bereinigung für KI-Modelle so wichtig?
HTML enthält viele Elemente wie Skripte, Stylesheets und komplexe Verschachtelungen, die für die Beantwortung einer inhaltlichen Frage irrelevant sind. Durch die Bereinigung wird der „Rauschen-zu-Signal“-Quotient verbessert, sodass die KI den eigentlichen Text besser erfassen kann.
Welchen Vorteil bietet Markdown gegenüber reinem Text?
Während reiner Text jegliche Struktur verliert, behält Markdown wichtige hierarchische Informationen wie Überschriften bei. Dies hilft dem LLM, den Kontext und die Relevanz verschiedener Abschnitte einer Webseite besser zu verstehen, während gleichzeitig weniger Token als bei HTML verbraucht werden.
Wie trägt dieser Scraper zur Kostensenkung bei?
Da die meisten LLM-Anbieter pro Token abrechnen, senkt jede Reduzierung der Eingabedaten direkt die Kosten. Durch das Entfernen von HTML-Ballast und die Konvertierung in das kompaktere Markdown-Format wird die Datenmenge minimiert, die an das Modell gesendet werden muss.